


Agent开发-详细路线
一份给所有 IT 人的 Agent 学习地图:从完全新手到资深架构师,找到自己的入口、知道学什么、明白往哪走。核心立场:模型选 SOTA,主战场是 Harness。 这是 IT 工程师的主场,不是 ML 研究员的专利。Part 0 · 谁应该读这份文档 · 怎么读
一份给所有 IT 人的 Agent 学习地图:从完全新手到资深架构师,找到自己的入口、知道学什么、明白往哪走。
核心立场:模型选 SOTA,主战场是 Harness。 这是 IT 工程师的主场,不是 ML 研究员的专利。
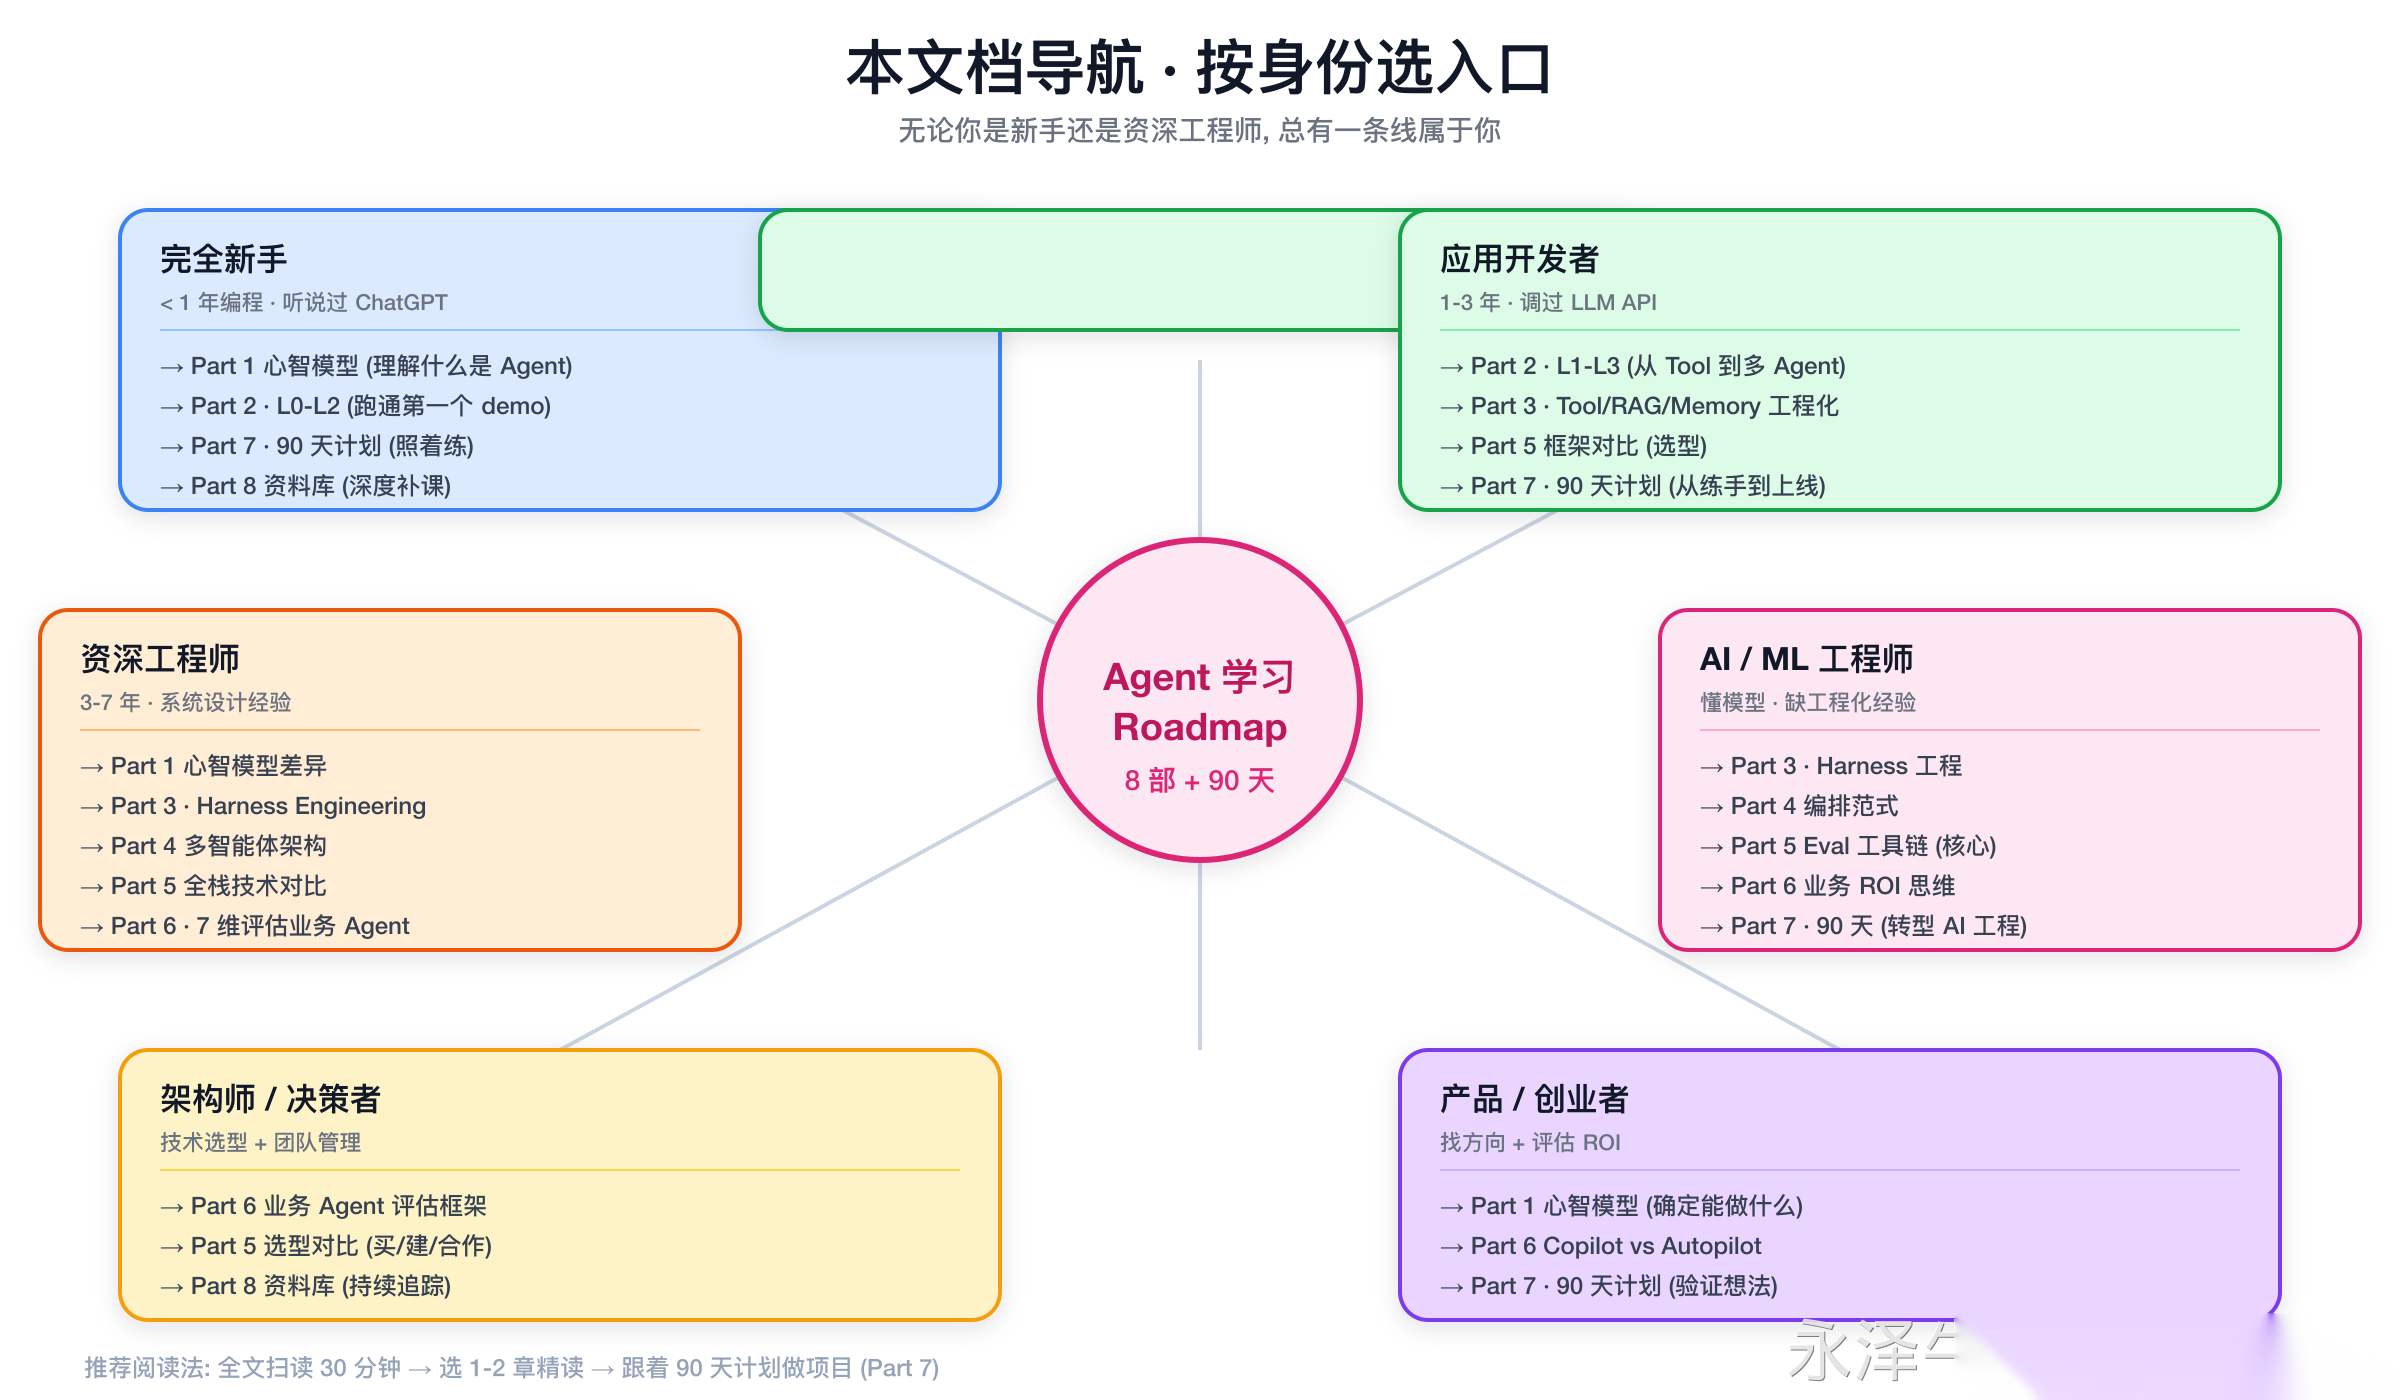
Part 0 · 谁应该读这份文档 · 怎么读
 Image
| 你是谁 | 主线 | 推荐路径 |
|---|---|---|
| 完全新手 ( |
Part 1 · 心智模型 · 什么是 Agent,为什么 2026 是分水岭
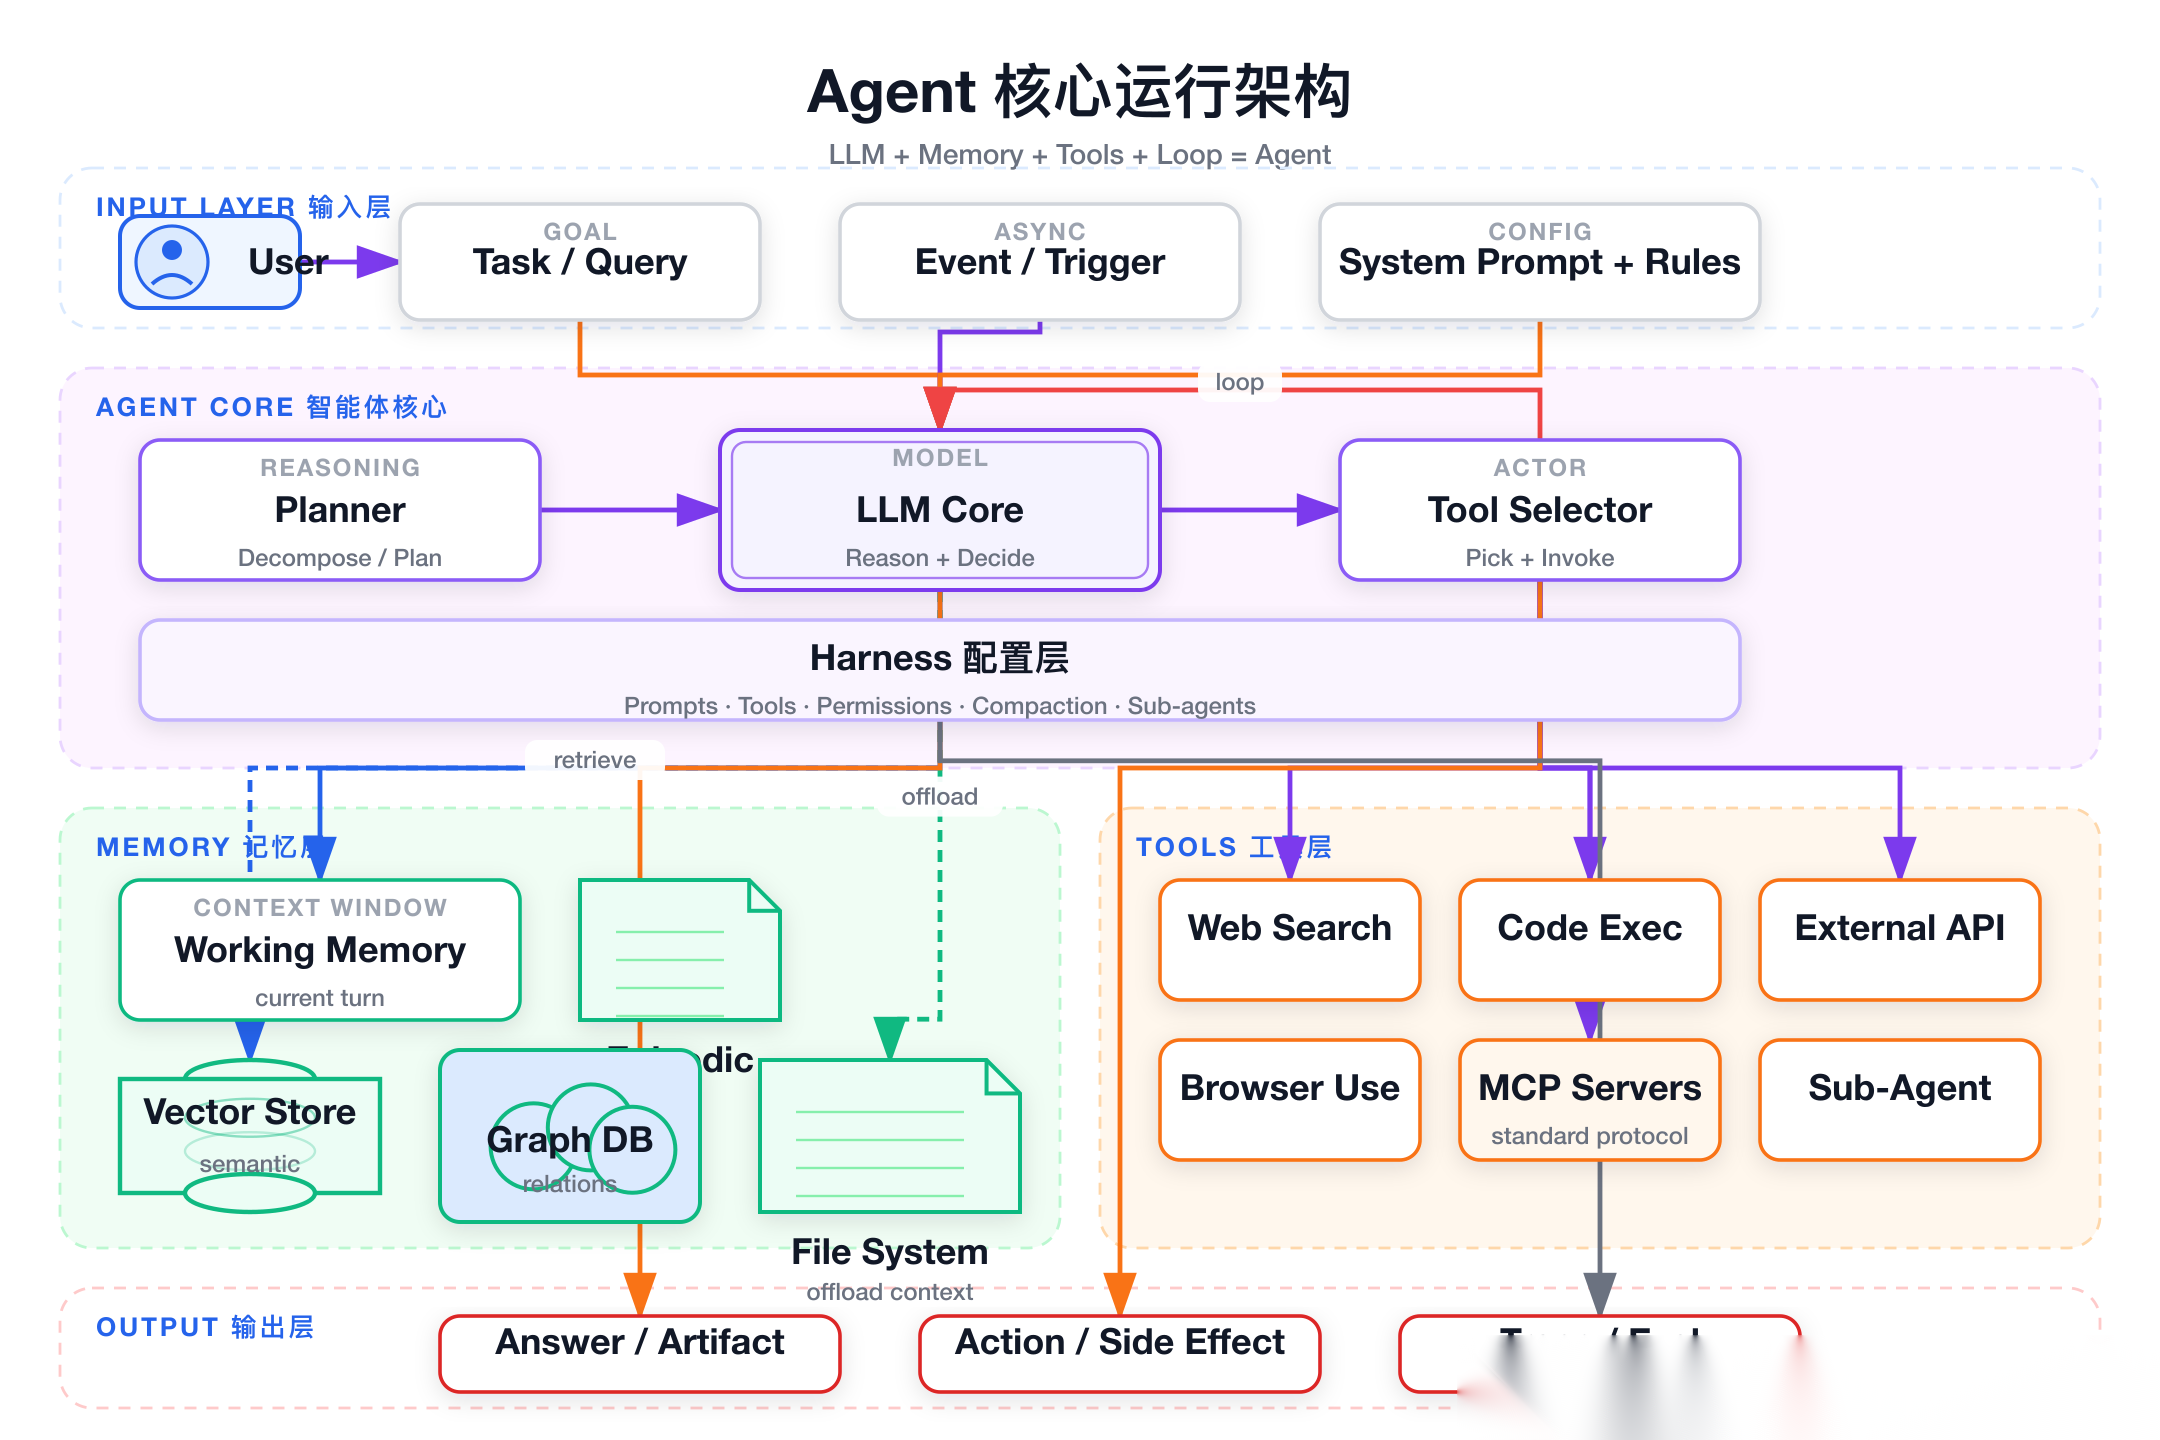
1.1 Agent 不是聊天机器人
 Image
一个 Agent = LLM (大脑) + Memory (记忆) + Tools (手脚) + Loop (持续运行)。
| 维度 | Chatbot | Agent |
|---|---|---|
| 输入 | 一次对话 | 一个目标 |
| 决策 | 单轮 prompt → 答 | 多轮规划 → 执行 → 反思 |
| 记忆 | 仅当前会话上下文 | 短期 + 长期 + 程序记忆 |
| 行动 | 纯文本输出 | 调用工具、改文件、发 API |
| 边界 | 用户每轮触发 | 自主循环到目标达成 |
关键判断:如果你的产品是「用户问一句答一句」,那就是 Chatbot。如果是「用户给个目标,系统自己跑直到完成」,那才是 Agent。
1.2 为什么 2026 是分水岭
三件事同时发生:
- 模型可靠性达到生产线:Claude 4.x / GPT-5 系列的 tool use 成功率 > 95%,长上下文稳定到 200K+
- 工程范式收敛:Harness Engineering(Anthropic 提出,业内迅速采纳)取代了「找一个最强模型」的天真思路
- 商业模型清晰:红杉 Julien Bek 的 Copilot vs Autopilot 框架被验证 — 真正的钱在 Autopilot(替代服务),不在 Copilot(加速工具) 结论:现在不是「学不学 Agent」的问题,是「用 IT 工程师身份切入哪一段」的问题。
1.3 三个最容易踩的认知坑
- 坑 1:把模型当 Agent。模型只是大脑,没有记忆没有手脚没有循环 = 不是 Agent。
- 坑 2:把 Workflow 当 Agent。固定流程(n8n、Dify 节点流)≠ Agent。Agent 必须能自主决定下一步。
- 坑 3:把 Demo 当生产。能跑通 hello world ≠ 能上线。生产 Agent 90% 的难点在 Harness,不在模型。
Part 1.5 · 周边知识地图 · 不必精通但要知道在哪
立场已经说过:模型选 SOTA,主战场是 Harness。但作为 Agent 工程师,到底要懂多少 ML / AI Infra?这一节给一张外延地图,划清三圈边界,避免把 IT 工程师又拉回 ML 研究员的主场。
三圈边界
| 圈层 | 范围 | 你要做什么 |
|---|---|---|
| 核心圈(必懂) | Transformer / Attention / Tokenizer / 上下文窗口 / 采样参数(temperature / top_p) | 天天调,必须能讲清楚 |
| 延伸圈(撞到再补) | vLLM / SGLang / KV Cache / 并行策略(TP/PP/DP)/ 量化 / Ollama 部署 | 自部署或优化成本时撞墙再补 |
| 远圈(知道有就行) | 预训练 / 后训练 / RLHF / DPO/PPO/GRPO / SFT / LoRA / 算子优化 / CUDA / NCCL/RDMA | 看论文不一脸懵就够,不要在这里花重投入 |
各圈推荐学习深度
核心圈 —— 能讲清楚才算懂:
- Transformer 的 Q/K/V 是什么,Attention 为什么是 O(n²)
- Tokenizer 的影响:为什么"中文 token 比英文贵",为什么 JSON Schema 越短越省钱
- 上下文窗口 与 Prompt Cache(5min TTL)的关系
- 采样参数对输出的实际影响(
temperature=0≠ 完全 deterministic) 延伸圈 —— 用过 + 知道在哪查: - 自部署一次 Llama / Qwen,通过 vLLM 或 SGLang,撞过一次 OOM
- KV Cache 是什么、为什么长上下文成本爆炸
- 知道 PagedAttention / Mooncake / FlexKV 这些名词存在(不必读论文)
- 并行策略 TP/PP/DP/EP 各自解决什么瓶颈(一句话能说清) 远圈 —— 知道概念边界即可:
- 知道 RLHF 三步走(数据采集 → Reward Model → 偏好优化),但不必读 PPO 原论文
- 知道 DPO / GRPO 是 PPO 的简化路线,能解释一句"为什么 DPO 不需要 Reward Model"
- 知道 LoRA 是低秩微调,但不必自己跑微调
- 知道有 Triton / CUDA / 算子融合 / GPU 体系结构这些东西,但 90% 的 Agent 工程师一辈子用不上
反直觉判断 · 工程师容易踩的"基础到应用"惯性
很多 IT 工程师会问:「是不是要先学完 Transformer 数学、跑通预训练,才能做 Agent?」
不是。这是大学教育带来的"先基础再应用"惯性,但 Agent 工程的真实主战场在 Harness 层(见 Part 3)。更高效的路径是:
**先做 Agent,撞墙再补 ML。**撞到上下文爆炸再补 KV Cache,撞到自部署成本再补 vLLM,撞到模型挑选再补评估方法。问题驱动学习 > 教材式扫盲。
反向读者:ML / AI 工程师怎么读这份文档
如果你是 ML/AI 背景反过来读:你的"远圈"恰好是别人的"核心圈",但你的短板恰好在 Harness / Memory / Eval / 业务理解这一侧。Part 3-6 才是你要重点补的,把训练那套世界观先放一放。
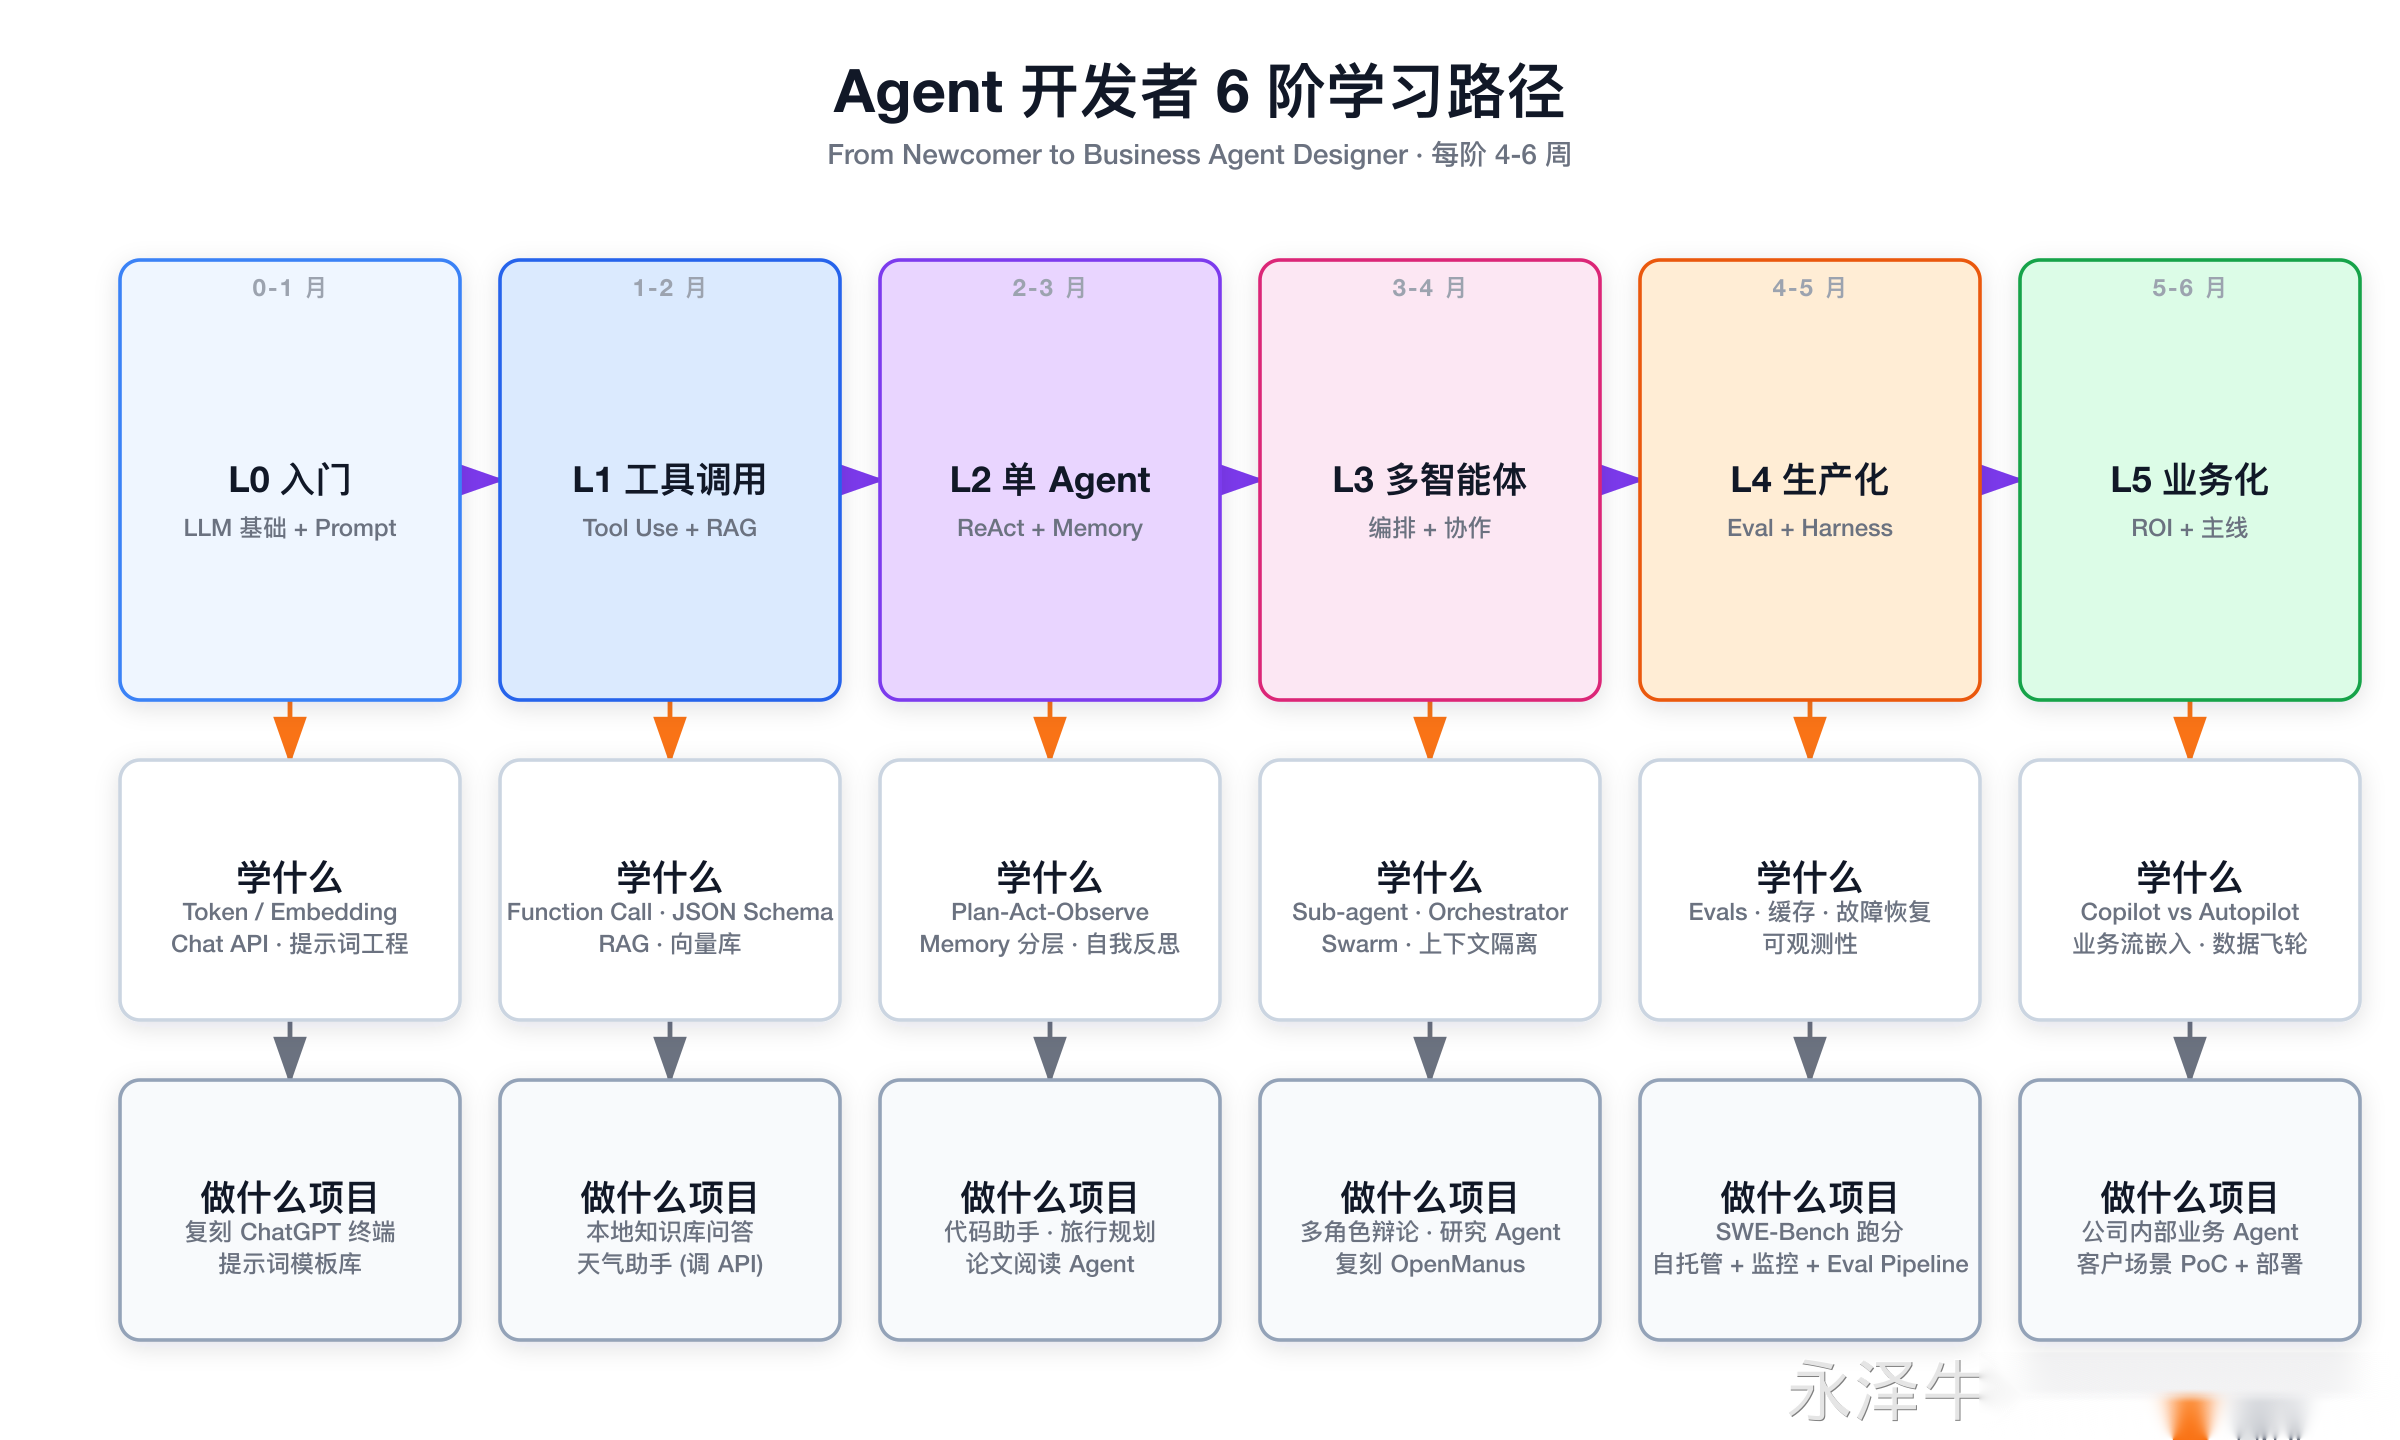
Part 2 · 学习阶梯 · 6 级能力模型
 Image
| 阶段 | 能做什么 | 关键技能 | 时间投入 | 典型产出 |
|---|---|---|---|---|
| L0 入门 | 用过 ChatGPT,理解 prompt | 基础 prompt 工程 | 1 周 | 写出可用的 prompt |
| L1 工具调用 | LLM 调函数,函数返回结果 | OpenAI Function Calling / Tool Use API | 2 周 | 一个调天气/搜索的小程序 |
| L2 单 Agent | ReAct 循环,能自己决定下一步 | LangGraph / Pydantic AI / smolagents | 3-4 周 | 一个能完成多步任务的 Agent |
| L3 多智能体 | 角色分工、状态共享 | AutoGen / CrewAI / LangGraph 多节点 | 4-6 周 | 一个研究助手 / 自动化团队 |
| L4 生产化 | 可观测、可评估、能上线 | LangSmith / Phoenix / Eval 框架 | 持续 | 上线一个有真实用户的 Agent |
| L5 业务化 | 能从业务角度选 Agent 方向 | Copilot/Autopilot 框架 + 7 维评估 | 持续 | 一个有清晰商业模型的 Agent 产品 |
自检 Checkpoint:
- 写不出 ReAct 循环的伪代码 → 还在 L1
- 不知道为什么要做 Reflexion → 还在 L2
- 没用过 LangSmith / Phoenix 看过 trace → 还在 L3
- 不能讲清楚自己 Agent 的失败率分布 → 还在 L4
- 算不出每个 task 的成本和 ROI → 还在 L5 90% 的人卡在 L2 → L3。原因不是技术,是没把 Eval 当回事。Eval 是 Agent 工程化的入场券。
Part 3 · Harness Engineering · 模型权重之外的一切
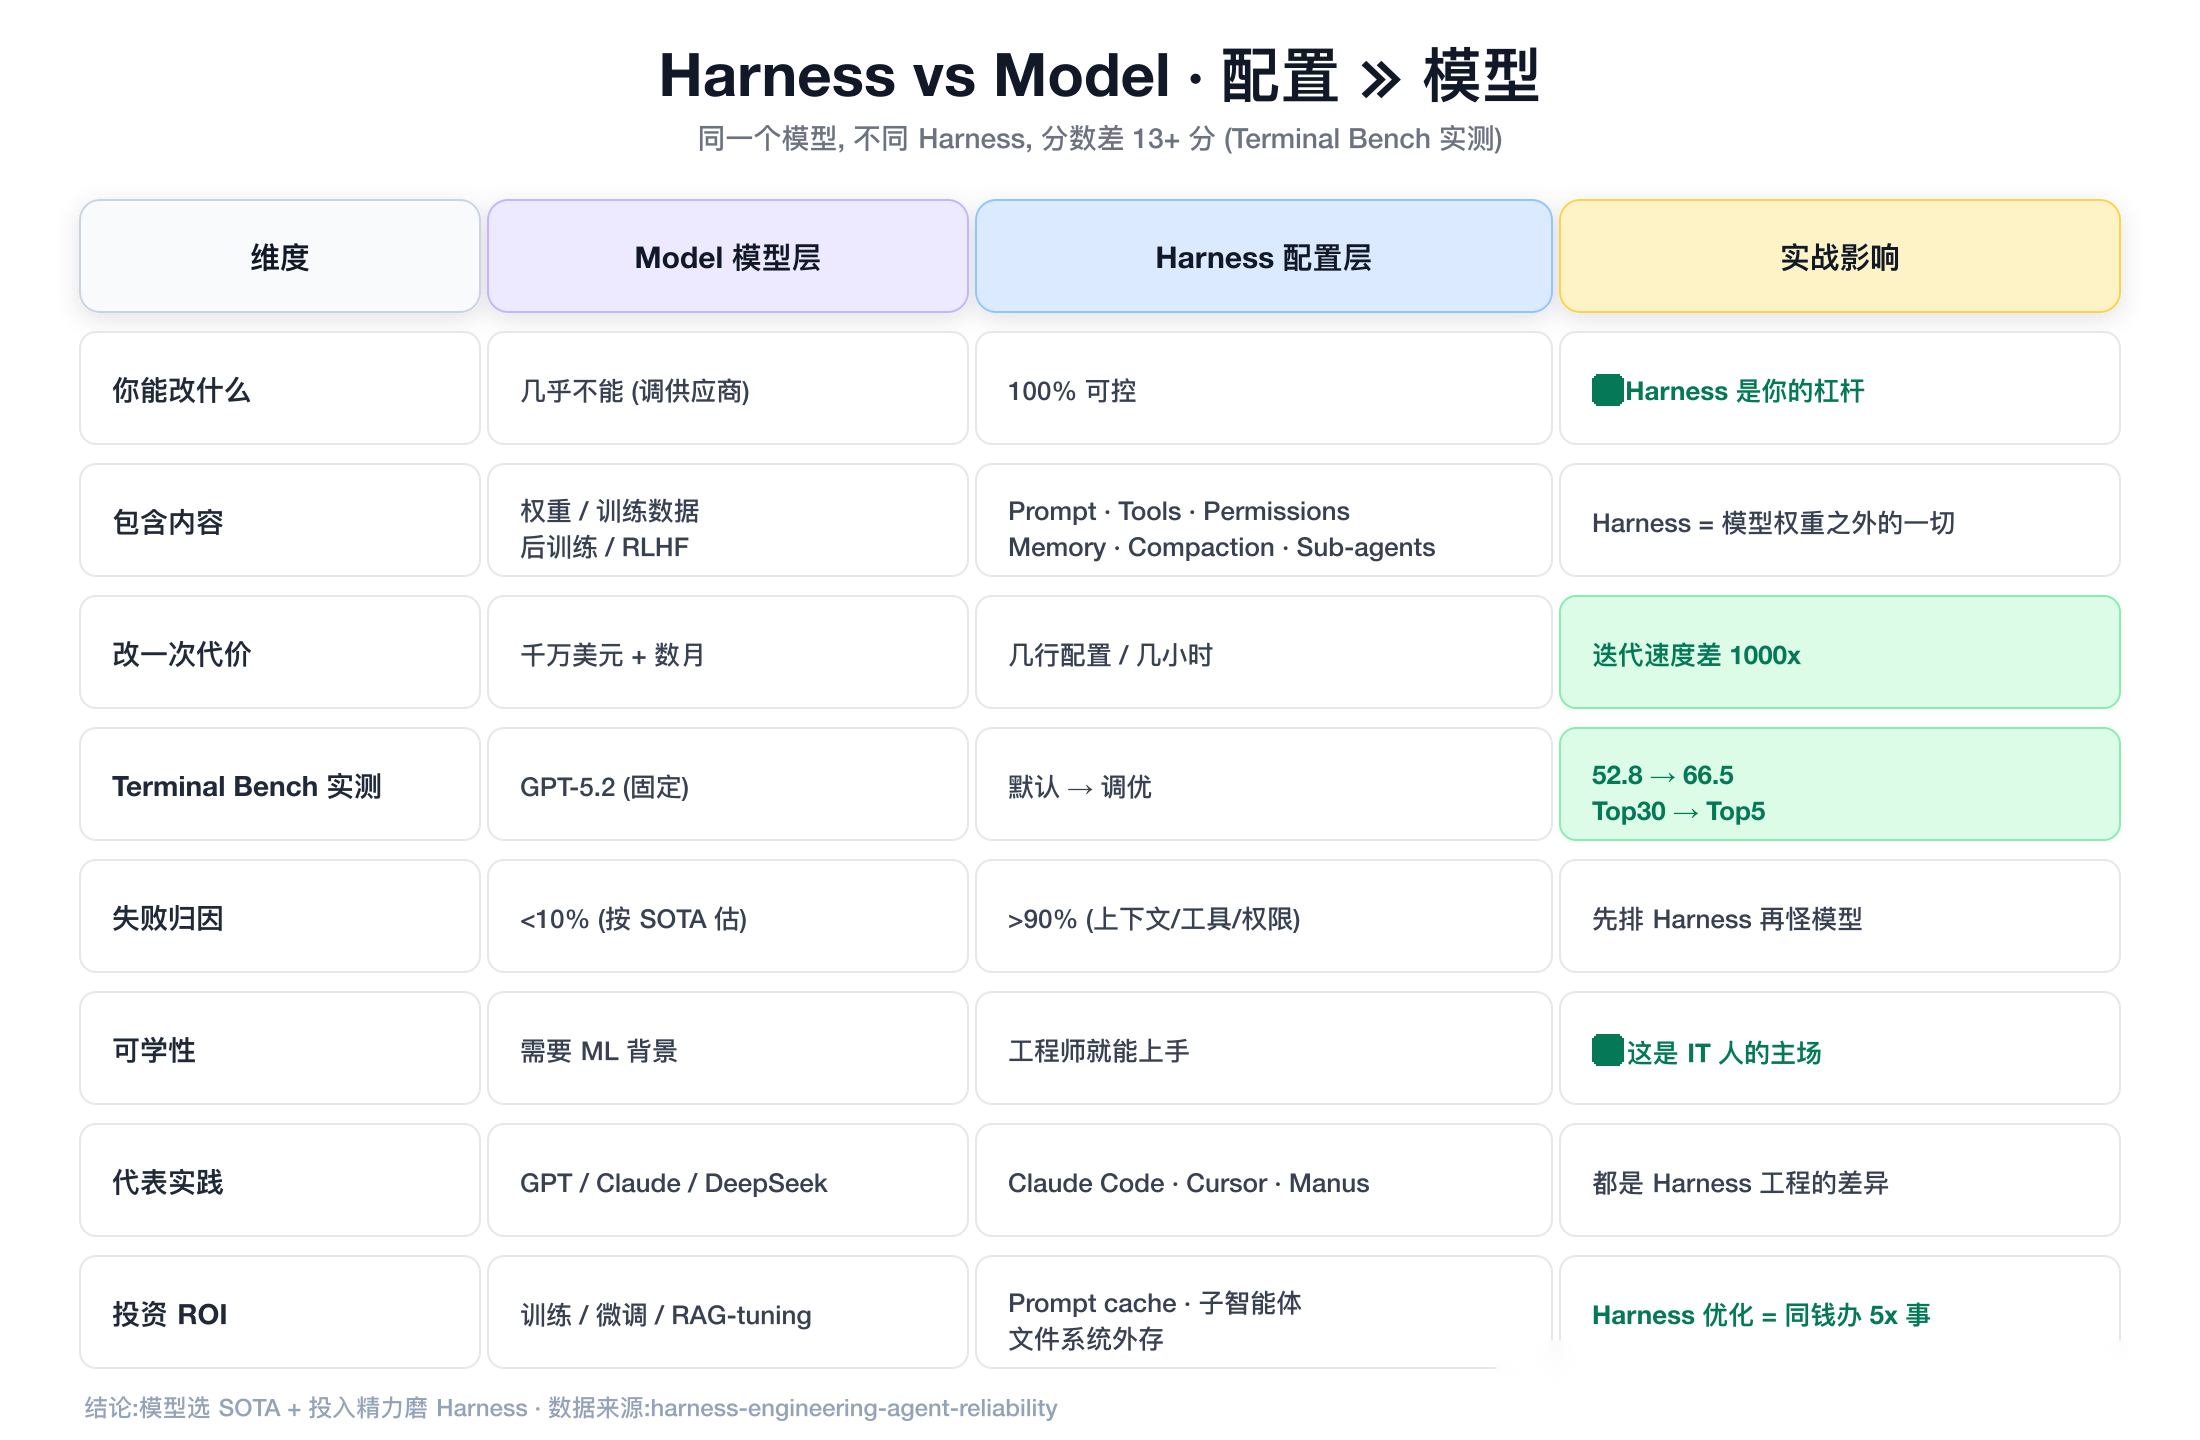
3.1 配置 ≫ 模型 — 一个反直觉的事实
 Image
Anthropic 在 Terminal Bench 上做了一组对照实验:同一个 GPT-5.2 模型,仅调整 Harness(prompt / tool / permission / memory / compaction),分数从 52.8 涨到 66.5,从榜单 Top 30 进到 Top 5。
数据出处:Anthropic Engineering, "Effective Context Engineering for AI Agents" 系列实验(2026)— https://www.anthropic.com/engineering
这意味着什么?
- 你换模型 ≈ 改 0-13 分的天花板(取决于换的是不是 SOTA)
- 你磨 Harness ≈ 改 0-13 分的实际表现,且改一次只要几小时
- 同样投入 100 美元,磨 Harness 比换模型多拿 5-10 倍效果
3.2 Harness 包含什么
Harness = Prompt 工程
        + Tool 设计 (粒度、副作用、错误恢复)
        + Permission 模型 (谁能改什么)
        + Memory 策略 (短期/长期/外存)
        + Compaction (上下文压缩)
        + Sub-agent 编排
        + Eval Loop
模型层你几乎改不了(除非自己训练),Harness 100% 可控。这就是 IT 工程师最大的杠杆点。
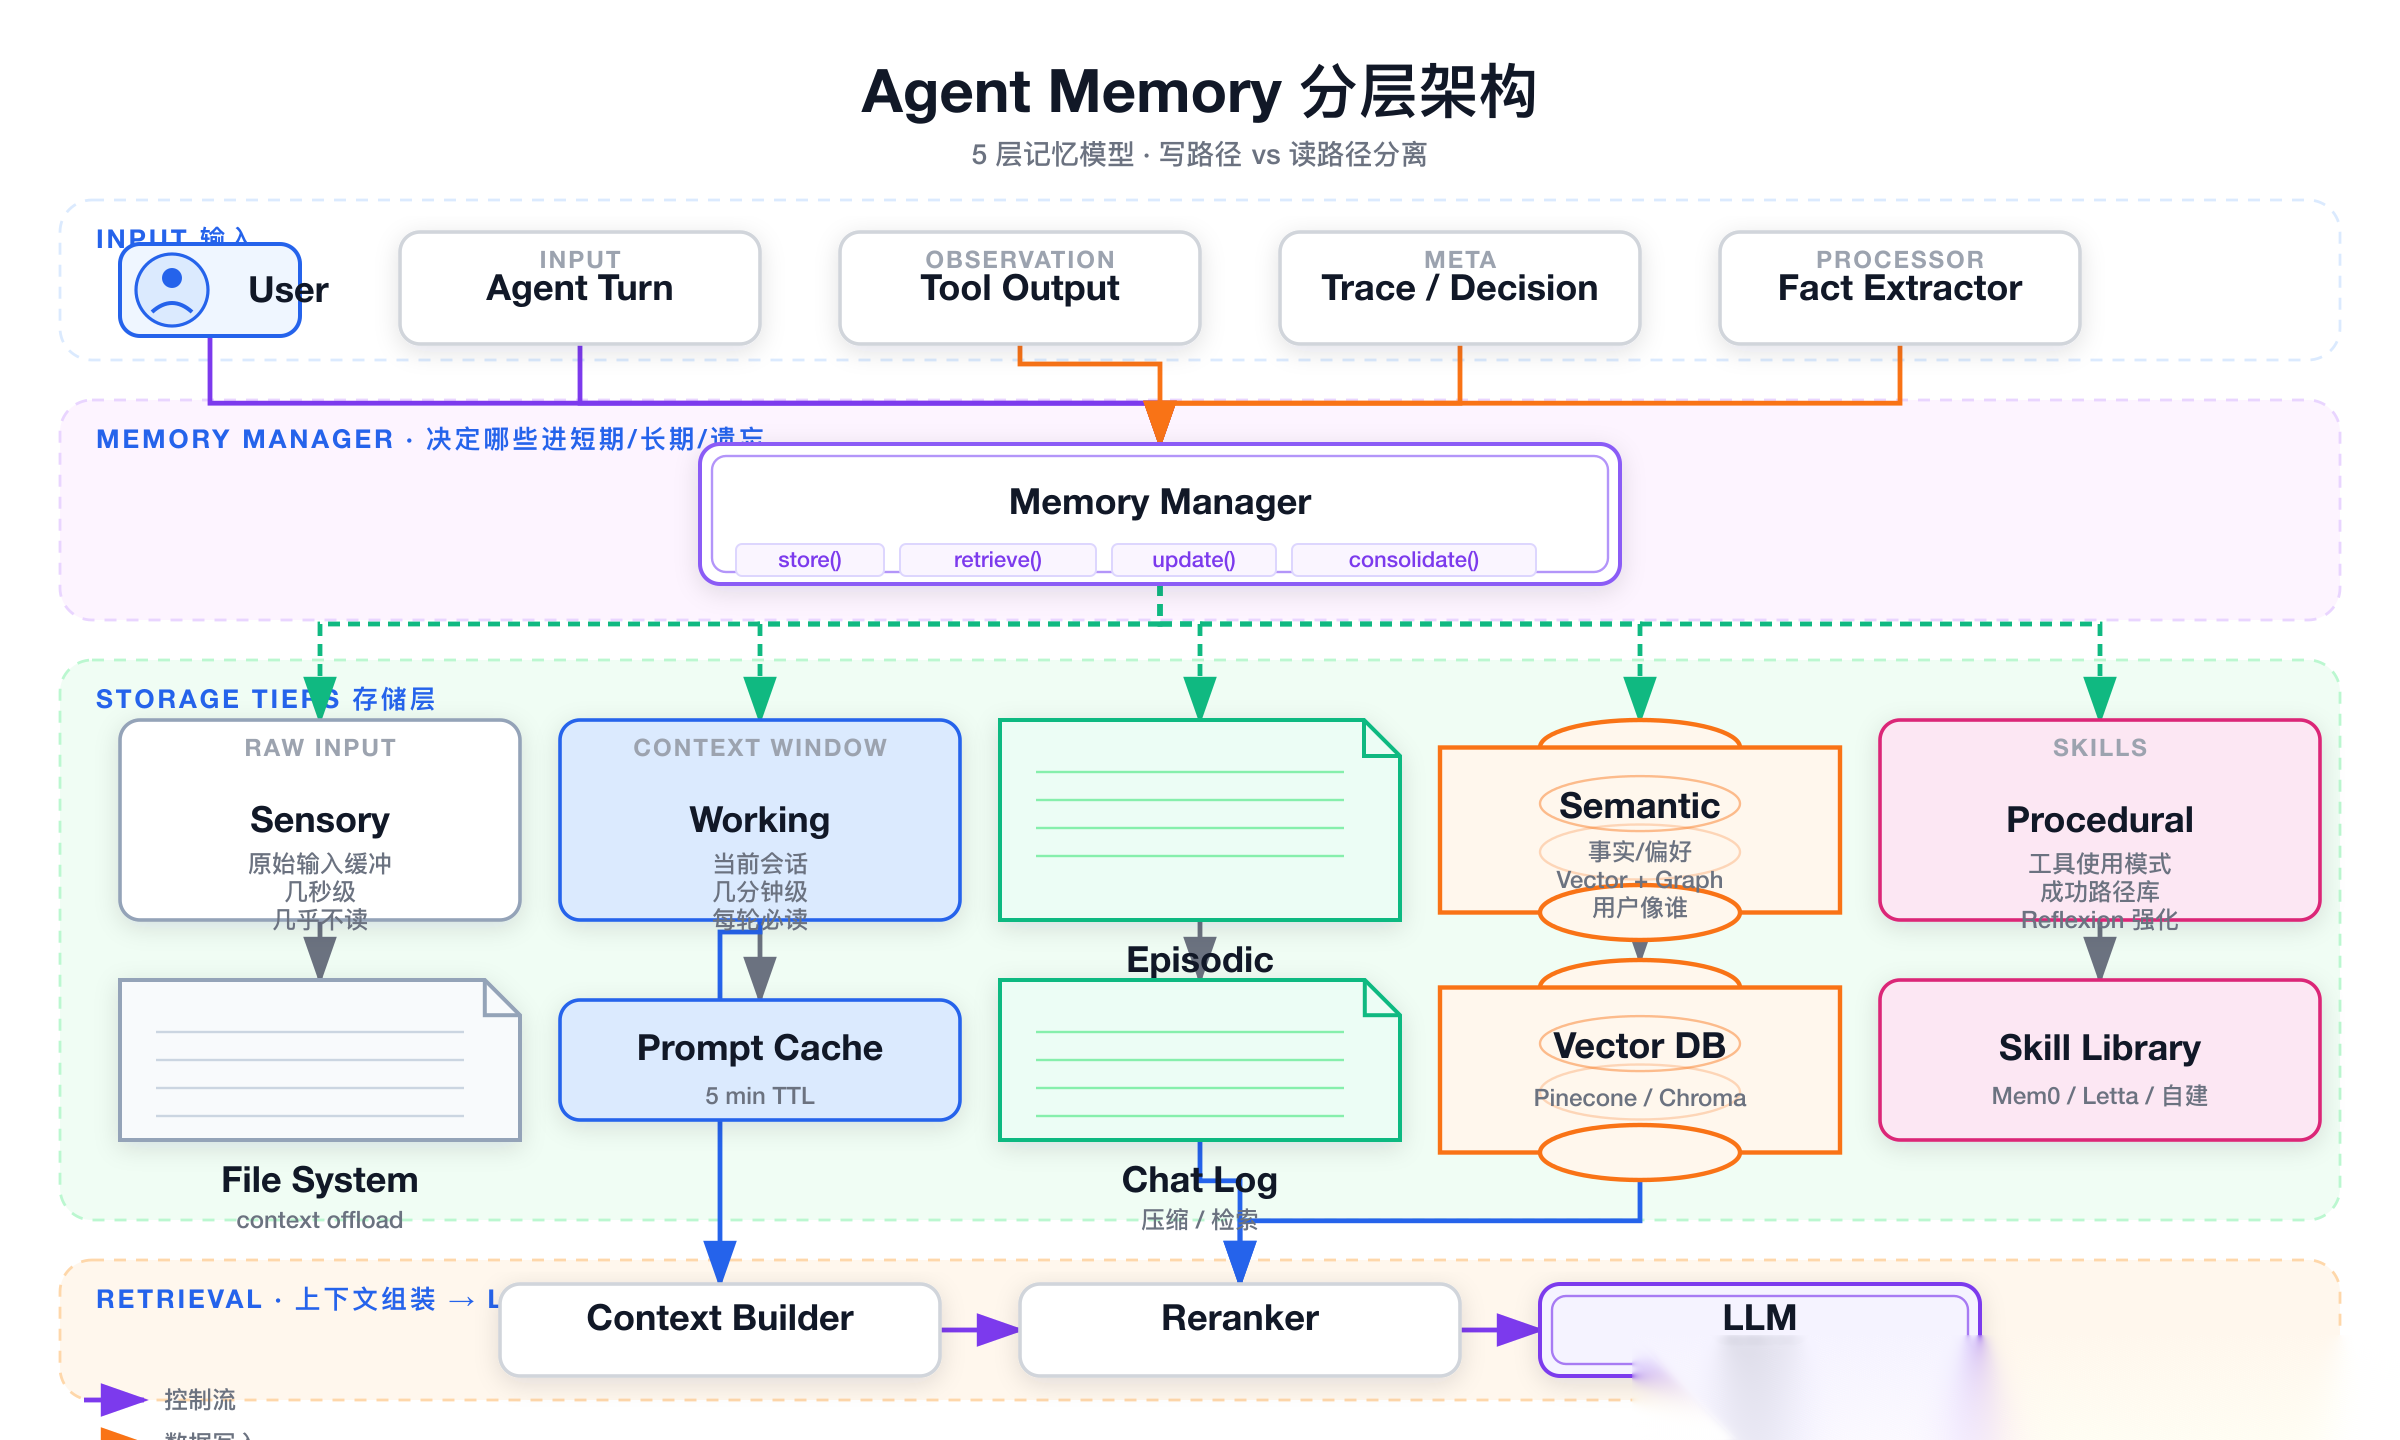
3.3 Memory · 5 层记忆架构
 Image
参考 Mem0 + MemGPT + 认知科学的分层模型:
| 层 | 类比 | 存储 | 何时读 |
|---|---|---|---|
| Sensory 感官 | 眼睛/耳朵的瞬时缓冲 | 文件系统 / 临时 buffer | 几乎不读 |
| Working 工作 | 当前会话的上下文窗口 | Prompt cache | 每轮必读 |
| Episodic 情景 | 过往会话的事件流 | Chat log + 检索 | 跨会话回忆时 |
| Semantic 语义 | 用户偏好 / 事实库 | Vector DB + Graph | 个性化推断时 |
| Procedural 程序 | 工具使用模式 / 成功路径 | Skill Library | 决定下一步动作时 |
关键工程决策:
- 写路径 vs 读路径分离 — Memory Manager 决定哪些进哪一层,每层的更新频率不同
- 不要全部进 Vector DB — 程序记忆用 Skill 库,情景记忆用结构化 chat log
- Compaction 是核心 — 让短期记忆持续蒸馏到长期,否则 token 成本爆炸
3.4 Tools · 设计原则
好的 Tool 设计 = 一半的 Agent 可靠性。三条铁律:
- 粒度对齐人类能理解的最小动作:「读文件」是 tool,「重构整个项目」不是
- 副作用可逆 / 可审计:每个 tool 调用要能 dry-run 或 rollback
- 错误返回要带建议:
Error: file not found不够,要说Error: file not found at /xxx, did you mean /yyy?参考实现:MCP(Model Context Protocol)已经成为事实标准,Cursor、Claude Desktop、Continue 全都接入。
Part 4 · 多智能体范式
 Image
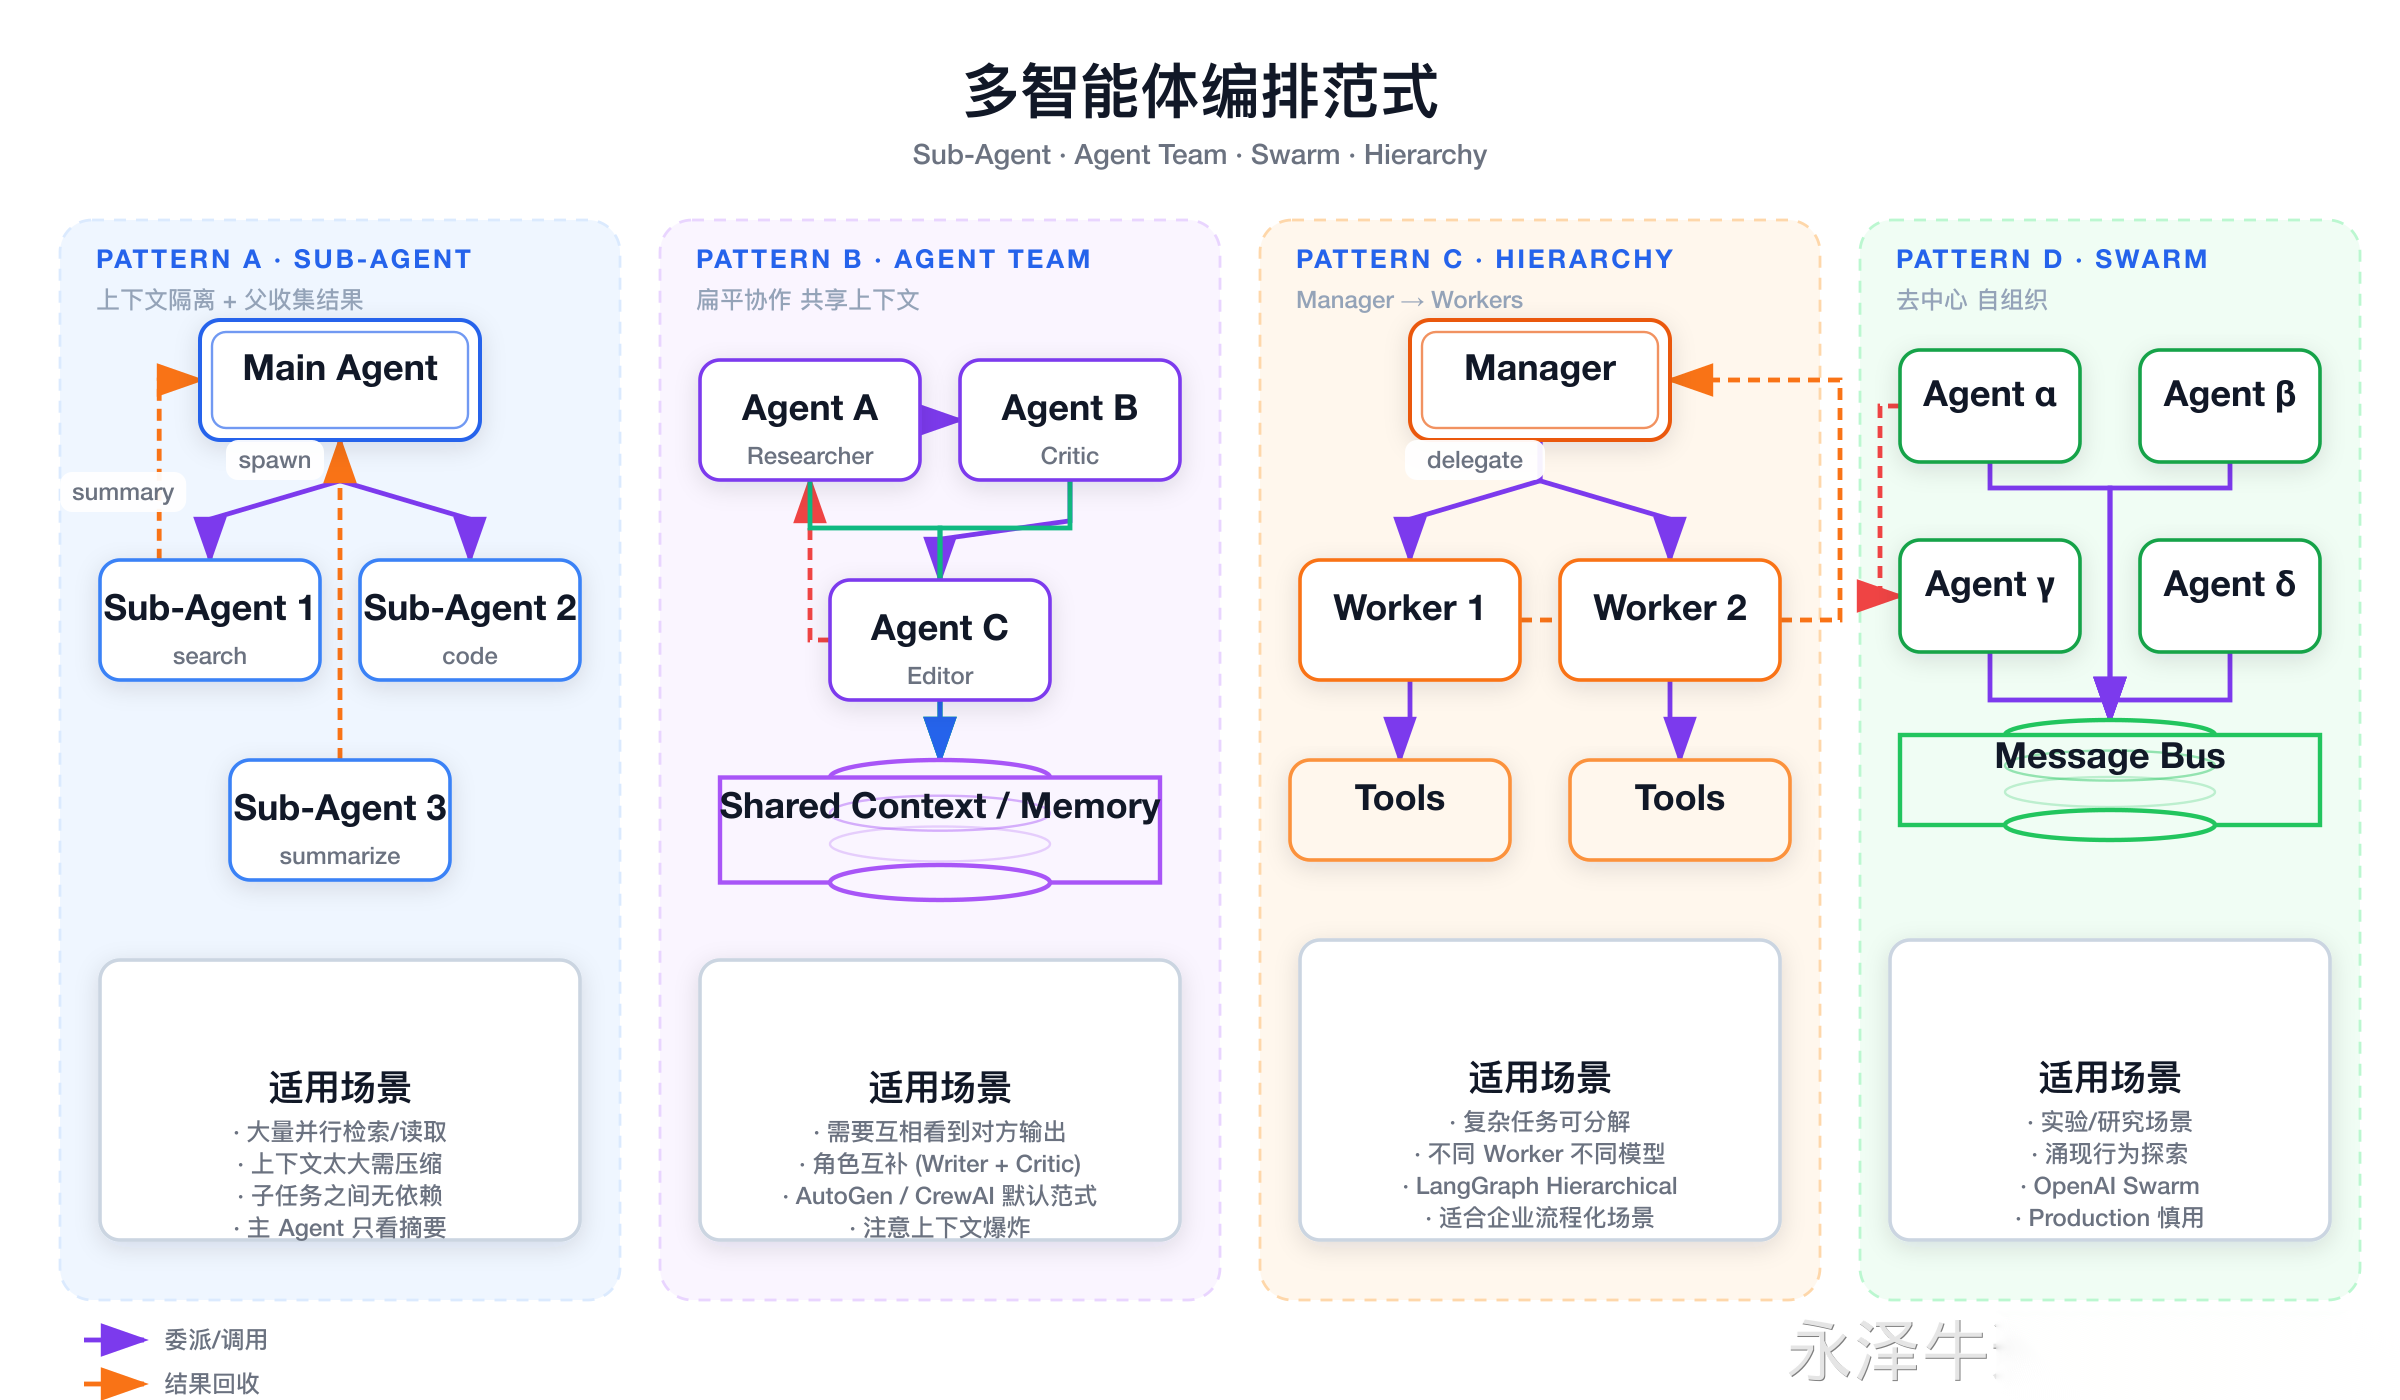
4.1 四种主流模式
| 模式 | 结构 | 适用 | 代表实现 |
|---|---|---|---|
| Sub-Agent | 主 Agent 派发任务给子 Agent | 单线性任务,子 Agent 是工具 | Claude Sub-agents, OpenAI Agents SDK |
| Agent Team | 平等协作,按角色分工 | 研究/写作/评审等流水线 | CrewAI, AutoGen GroupChat |
| Hierarchy | 层级管理,Manager → Worker | 复杂大任务、需要监督 | LangGraph Supervisor 模式 |
| Swarm | 去中心化,按话题路由 | 客服路由、多专家会诊 | OpenAI Swarm (deprecated → Agents SDK) |
4.2 多 Agent vs 子 Agent — 不要混淆
- Sub-Agent = 把一段子任务封装成「黑盒工具」,主 Agent 不关心内部
- Agent Team = 多个 Agent 平等共享上下文,互相看得见对方的输出 90% 的「多 Agent」需求其实是 Sub-Agent 就够了。强行搞 Team 会带来:
- 上下文同步成本爆炸
- 无限循环(A 等 B 等 A)
- 角色重叠 / 责任不清 经验法则:能用 Sub-Agent 就别用 Team;能用单 Agent 就别用 Sub-Agent。
4.3 上下文管理 — 多 Agent 最容易爆炸的点
- 不要把所有历史塞给每个 Agent — 用 summary + 检索
- 用 Prompt Cache 复用系统提示 — 5 分钟 TTL,Anthropic 特性
- 用文件系统当外存 — 大量中间结果不要进上下文,让 Agent 按需读
Part 5 · 技术栈全景 · 怎么选
 Image
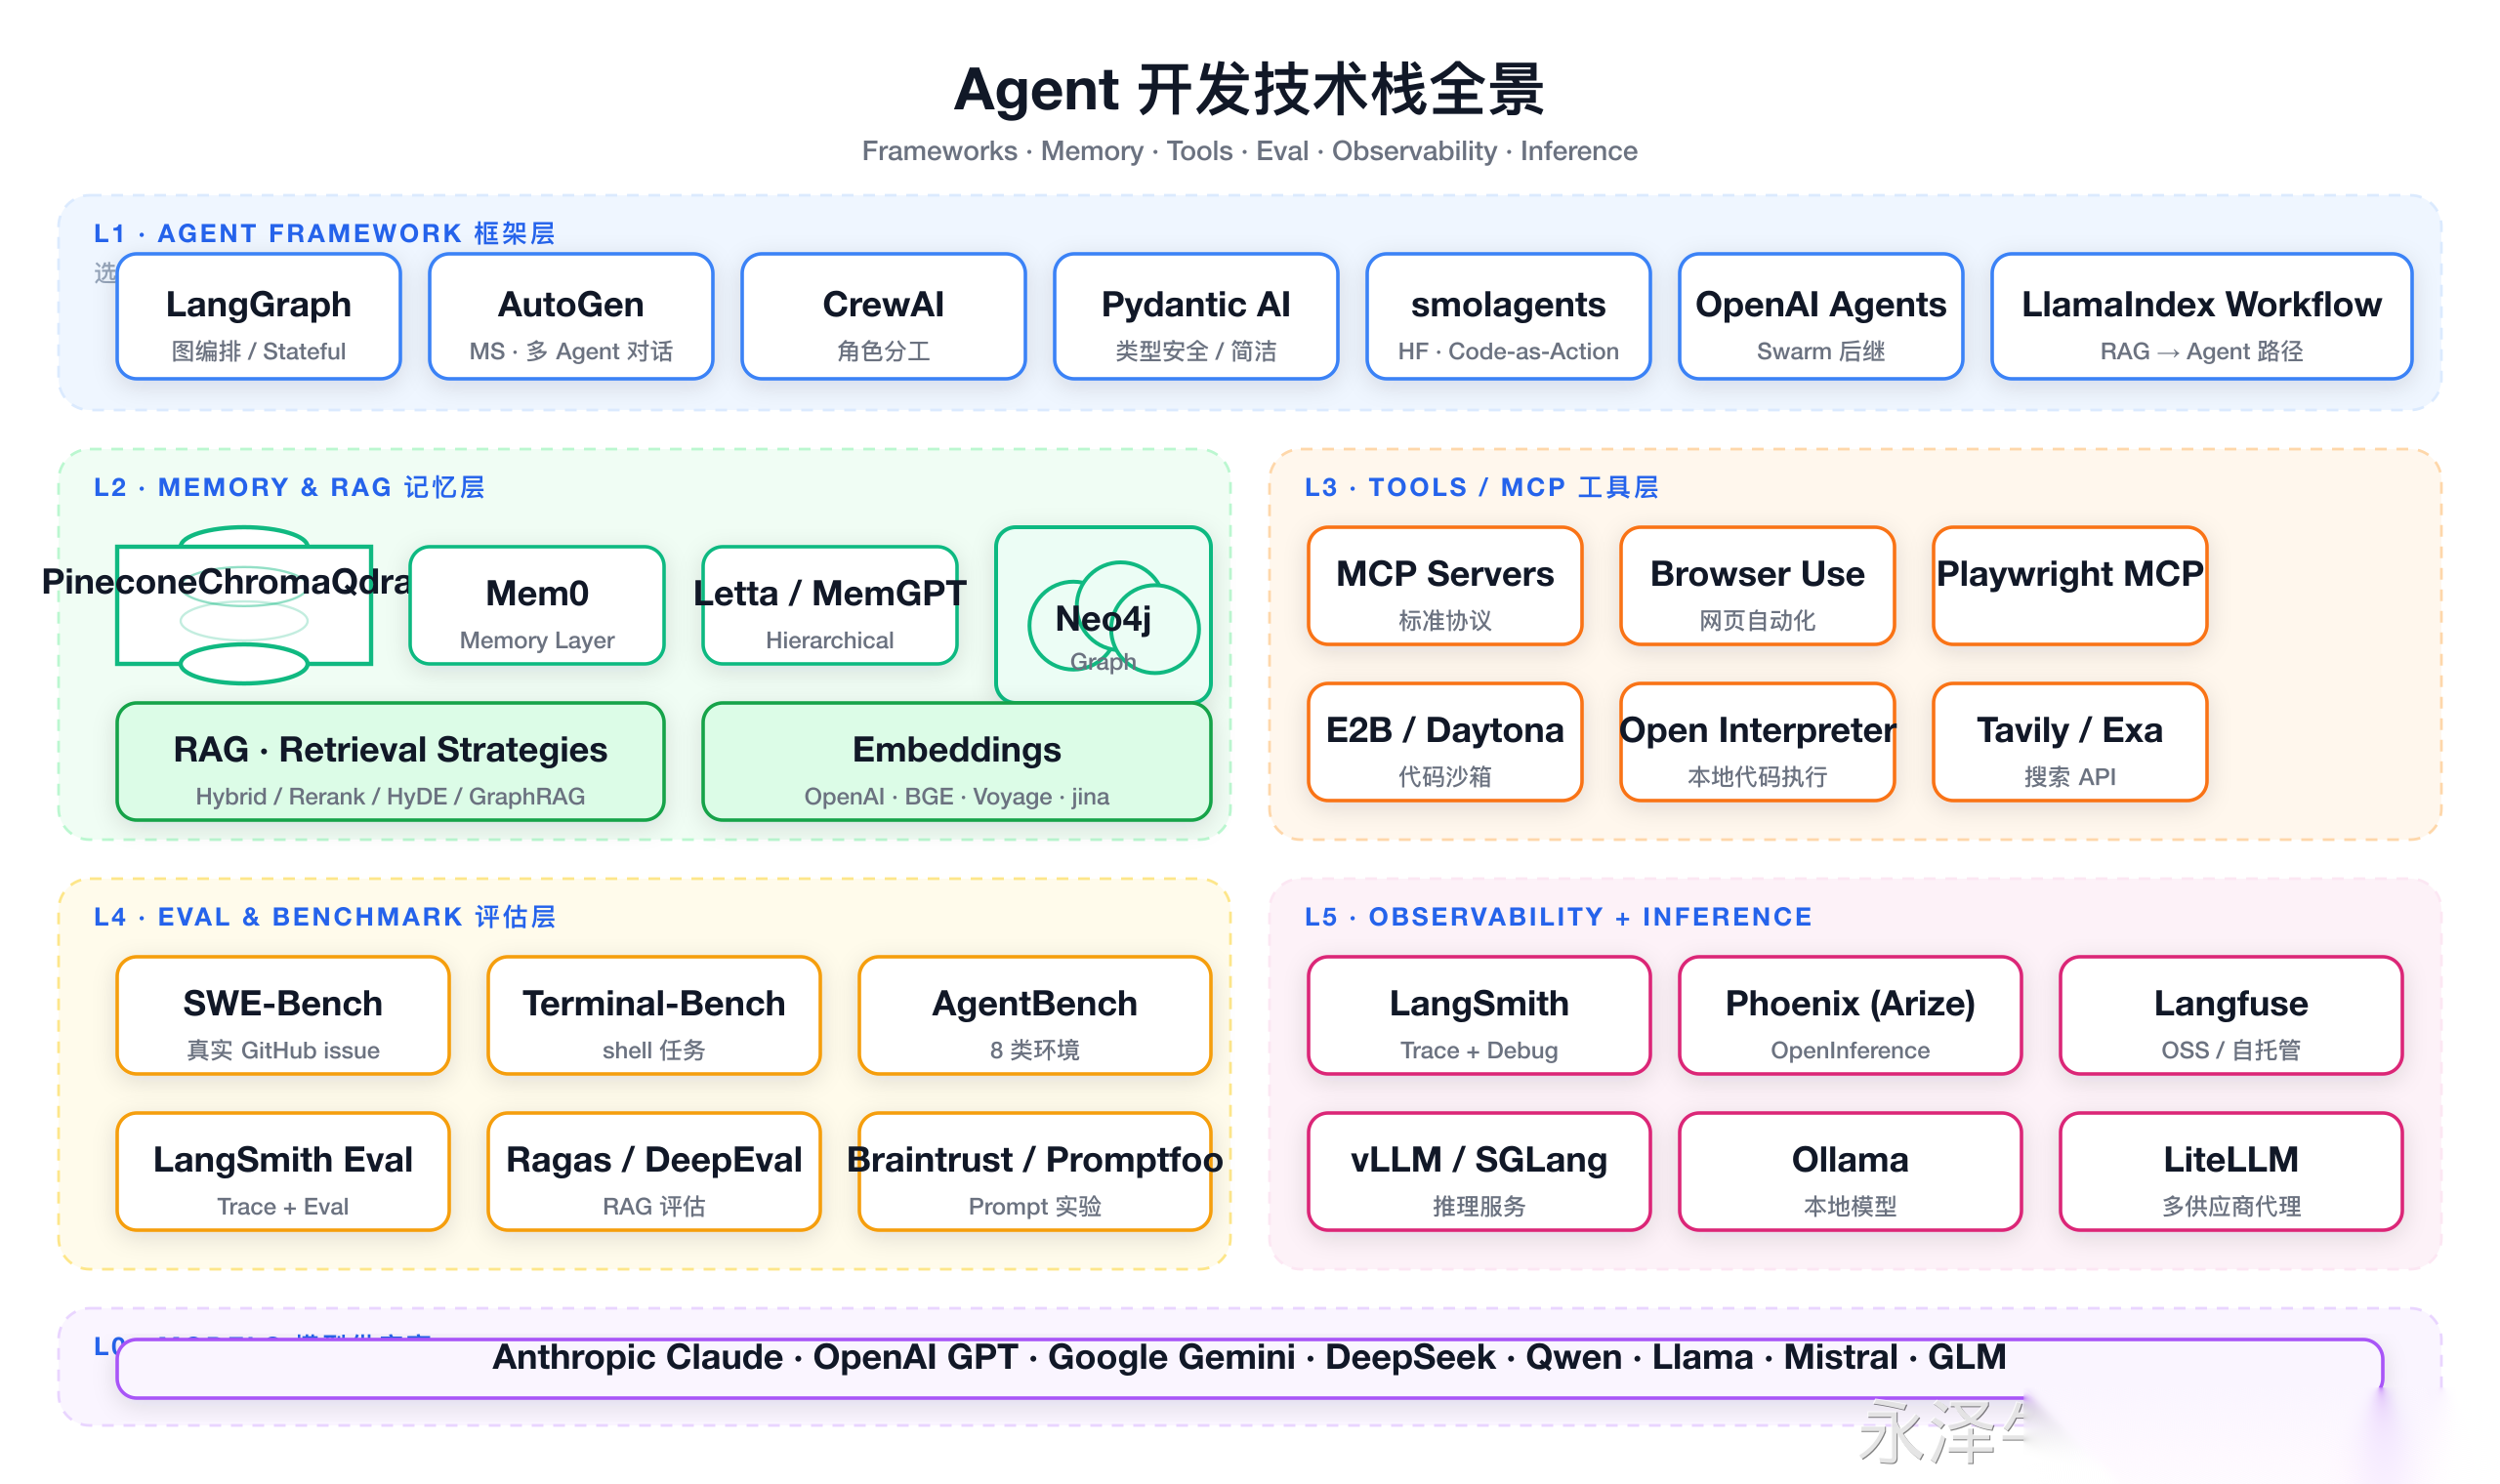
5.1 框架层(L1)— 核心选型
| 框架 | 出品 | 长板 | 适用 | 不适用 |
|---|---|---|---|---|
| LangGraph | LangChain | 图编排 + Stateful + 生态最大 | 多分支、需要状态机 | 想要简洁的 |
| AutoGen | Microsoft | 多 Agent 对话原生 | 角色协作 / 研究助手 | 单 Agent |
| CrewAI | 社区 | 角色分工抽象清晰 | 流水线类任务 | 复杂控制流 |
| Pydantic AI | Pydantic 团队 | 类型安全 + 极简 | 后端工程师 / 严肃业务 | 需要可视化编排 |
| smolagents | HuggingFace | Code-as-Action(让 LLM 写代码而非 JSON) | 数据分析 / 计算密集 | 简单 tool 调用 |
| OpenAI Agents SDK | OpenAI | Swarm 后继 + 官方加持 | OpenAI 生态深度集成 | 多供应商 |
| LlamaIndex Workflow | LlamaIndex | RAG → Agent 平滑路径 | 已用 LlamaIndex 做 RAG | 从零开始 |
选型建议:
- 新手 / Demo:smolagents 或 Pydantic AI(最少抽象)
- 生产 / 复杂控制流:LangGraph
- 多 Agent 协作:AutoGen 或 CrewAI
- 已有 RAG 系统:LlamaIndex Workflow
5.2 Memory 层(L2)
- Vector DB:Pinecone / Chroma / Qdrant(Chroma 最易上手,Qdrant 性能最强)
- Memory 中间件:Mem0(最热)/ Letta(前 MemGPT,分层最完整)
- Graph:Neo4j(关系密集场景)
5.3 Tools / MCP 层(L3)
- MCP Servers:标准协议,未来一定的方向
- Browser Use / Playwright MCP:网页自动化
- E2B / Daytona:代码沙箱(不要在自己机器上 run AI 写的代码)
- Tavily / Exa:搜索 API(替代 Google)
5.4 Eval & Benchmark 层(L4)— 最容易被忽视的关键
| 工具 | 评估什么 |
|---|---|
| SWE-Bench | 真实 GitHub issue 解决率 |
| Terminal-Bench | shell 任务(Anthropic Harness 实验场) |
| AgentBench | 8 类环境综合评估 |
| LangSmith Eval | 自己业务任务的 Trace + Eval |
| Ragas / DeepEval | RAG 系统专用 |
| Braintrust / Promptfoo | Prompt 实验管理 |
忠告:没有 Eval 的 Agent 项目 = 没有单元测试的代码项目。早期就要建。
5.5 Observability + Inference 层(L5)
- LangSmith(LangChain 出品,Trace 最丰富)
- Phoenix(Arize,OpenInference 标准,自托管友好)
- Langfuse(OSS,自托管 + 成本最低)
- vLLM / SGLang:自部署推理服务
- Ollama:本地跑 Llama / Qwen
- LiteLLM:多供应商代理(一键切换 OpenAI/Anthropic/DeepSeek)
5.6 Models 层(L0)
- Claude 4.x(Anthropic)— Tool Use / 长上下文最强
- GPT-5 系列(OpenAI)— 通用最稳
- Gemini 2.x(Google)— 多模态 + 长上下文
- DeepSeek(开源 + 性价比最高)
- Qwen / GLM(中文场景)
- Llama 4 / Mistral(自部署) 实战配置:用 LiteLLM 做代理,根据任务路由。便宜模型做粗筛,贵模型做关键决策。
5.7 ADK 路线 vs Framework 路线 · 另一条入口
真实疑问:"框架太厚、世界观太重,能不能直接用底层工具自己搭循环?"答案:可以。这就是 ADK (Agent Development Kit) 路线 —— 厂商把 Tool / Memory / Trace / Streaming 等"积木"包好,循环和编排你自己写。Framework 是「我替你定义了世界」,ADK 是「我把零件给你,你拼」。
两条路线本质区别:
| 维度 | Framework 框架路线 | ADK 工具包路线 |
|---|---|---|
| 抽象层级 | 高(StateGraph / Crew / Team 等概念) | 低(自己写循环、自己管 state) |
| 自由度 | 低(被框架世界观约束) | 高(想怎么搭怎么搭) |
| 上手成本 | 中(要学框架概念) | 低(就是写代码) |
| 生产化路径 | 框架自带(trace / eval / 部署) | 需要自己拼或借中间件 |
| 调试体验 | 好(自带可视化 trace) | 早期难(自己接 OpenTelemetry / Phoenix) |
| 代表 | LangGraph / CrewAI / AutoGen | Google ADK / Genkit / Vercel AI SDK |
| 适合谁 | 业务清晰、想快速搭多 Agent 流水线 | 严肃后端工程师、要深度控制和可维护性 |
主流 ADK 一览:
| ADK | 出品 | 主语言 | 长板 | 链接 |
|---|---|---|---|---|
| Google ADK | Python / Java / JS / Go | 多语言齐全、A2A 协议、MCP 一等公民、Sequential/Parallel/Loop/Planner Agent 原语 | https://google.github.io/adk-docs/ | |
| Firebase Genkit | Google (Firebase) | JS / Go / Python / Dart | 类型化 Flow + Zod Schema + Dev UI Tracing + Express/Flask 部署一行 | https://genkit.dev/ |
| Vercel AI SDK | Vercel | TypeScript | 流式优先、AI Gateway 切供应商一行、前端最顺 | https://ai-sdk.dev/ |
| Microsoft Agent Framework | Microsoft | .NET / Python | 企业 Microsoft 栈、Semantic Kernel 后继 | https://github.com/microsoft/agent-framework |
| Mastra | 社区 | TypeScript | 介于 ADK 和 Framework 之间,自带 workflow / RAG / eval | https://mastra.ai/ |
| Pydantic AI | Pydantic 团队 | Python | 类型安全 + 极简,几乎是"带类型的 ADK" | https://ai.pydantic.dev/ |
怎么选:
- 严肃后端 / 类型安全 / 控制力最强 → Google ADK (Python/Java) 或 Pydantic AI
- TypeScript 全栈 / Next.js 项目 → Vercel AI SDK 或 Mastra
- JS + Firebase 生态 / 想要 Dev UI 看 trace → Genkit
- .NET 团队 / 企业 Microsoft 栈 → Microsoft Agent Framework
- 多 Agent 编排为主、不想自己搭循环 → 还是回到 LangGraph / AutoGen / CrewAI ADK 路线的代价(不要美化):
- 你要自己写 ReAct 循环、自己管 trace、自己接 eval pipeline
- 调试早期会更难(没有现成的可视化)
- 多 Agent 编排要自己造抽象,或引入小型库补足
- 团队换人成本高(没有标准化的「学过 LangGraph 就能上手」模板) 经验法则:
- 团队对 LLM 工程理解深 / 长期维护一个产品 → ADK 更合适
- 团队第一次做 Agent / 要快速验证业务 → Framework 更合适
- 不要在一个项目里混用两套 —— 否则两边的好处都拿不到,调试地狱叠加 一句话总结:Framework 帮你写好脚手架但限制了形状,ADK 把零件丢给你自由度拉满。Pydantic AI 站在中间,是想要类型安全又不想被 LangGraph 绑架的人的甜点。
Part 5.5 · 实战案例 · 文生图 / 文生视频 Agent 的多 API 架构
抽象的概念学完,最直接的练手是搭一个业务型创作 Agent。这一节用一个文生图/文生视频 Agent的典型架构,把 Part 1-5 的概念落到实际工程。
场景假设:用户输入一段需求("给我做一张电商主图,红色背景,突出新款球鞋"),Agent 自己决定用哪个图像模型、生成几个候选、出 Option Card 让用户选、必要时切换到视频生成。
5.5.1 多模型路由 — 不要押注单一 API
文生图/视频领域没有一个模型能通吃所有任务。一个生产级 Agent 必然要管多个 API:
| 任务类型 | 模型选择思路 |
|---|---|
| 简单平面图、电商主图 | 走便宜 / 快速的图像 API(速度优先) |
| 复杂版式、强 prompt 遵循 | 走强 prompt 理解的高端图像 API(质量优先) |
| 视频片段、动效 | 走视频生成 API(不同供应商擅长不同时长) |
| 图像编辑 / 局部重绘 | 走专门的 inpainting / image-to-image API |
| 兜底 fallback | 留一个稳定但平庸的模型,主 API 失败时顶上 |
关键决策:路由逻辑由 Agent 自己判断,不要让用户去选模型。Agent 看到 prompt 后用一段简短规则 + LLM 判断走哪条路。这是 Procedural Memory 的典型用法。
5.5.2 Memory 至少要分两个文件
业务 Agent 一上来就给一堆碎记忆塞进 Vector DB = 技术债。最低限度先分两类:
- workbook.md(无状态规则)→ Procedural / Semantic
- "电商主图:默认 1024x1024,背景纯色优先"
- "美妆海报:人脸保留度优先,避开 X 模型已知的塑料感问题"
- files.md(任务级历史)→ Episodic
- "上传的素材 ID a3f2 上次用 X 模型渲染失败,下次直接用 Y"
- "用户编号 042 偏好暖色调" 读路径分离:每轮先读 workbook(规则),再按需检索 files(这个素材/这个用户用过什么)。混在一起就是技术债。
5.5.3 Agent Loop 的几个生产必备件
不管框架选 LangGraph 还是自写,下面这几样生产环境必须有,不然必崩:
- Session 持久化 — message history 留在外部对象上,循环里别重建
- Stream 回调钩子 — token / tool_call 增量回吐到前端,不然用户面对 30 秒的 loading 会以为卡死
- 工具并行执行 — 同一轮要调 5 个 API 时用线程池,串行 = 体验地狱
- Loop 上限熔断 — 比如
max_loop_count = 16,超了就强制结束防止 token 烧穿 - 单工具重试上限 — 失败重试 1 次就放弃,无意义重试只会浪费钱
5.5.4 Tool 接口的最小契约
文生图/视频 Agent 的工具不能是「裸调 API」。统一抽一层:
- 装饰器 + 类型化参数(Pydantic / TypedDict 都行)— 让 Agent 看到的工具签名稳定
- 标准化返回结构 — 至少包含
success: bool、output: ...、error: ...、hint: ...四个字段,错误带建议 - 副作用隔离 — 不要让 Agent 直接读写真实磁盘,挂一个 VirtualDisk / sandbox 层
- 强制时间感知 — 给 Agent 一个
time_now()工具,否则它会幻觉日期 - Web 搜索 + 时效兜底 — 涉及"最新趋势"的需求,强制走搜索而不是凭记忆答
5.5.5 UX 工具:Option Card 而不是堆文字
文生图/视频 Agent 给用户的输出不应该全是文字解释。给一个 option_card 工具,让 Agent 在生成多个候选时返回结构化 block:
option_card(
  title="给你做了 3 版主图",
  options=[
    {id: "v1", thumb: "...", note: "强对比版"},
    {id: "v2", thumb: "...", note: "极简版"},
    {id: "v3", thumb: "...", note: "节日感版"}
  ]
)
UI 渲染成可点选卡片,比"我做了三版,你看看哪个好" + 三段描述强 10 倍。Agent 工程不只是后端,UX 工具的设计也是 Harness 的一部分。
5.5.6 自检对照表 · 你的业务 Agent 占了几项?
| 应该有 | 没有的代价 |
|---|---|
| 一份明确的 System Prompt(含输出契约 / JSON Schema) | LLM 输出格式漂移,下游解析爆炸 |
| 多模型路由 + fallback 链 | 单 API 故障时整个 Agent 趴窝 |
| Stream 回调 / 实时进度 | 用户看不见进度,30 秒后离开 |
| Loop 上限 + Tool 重试上限 | 失控时 token 一晚上烧光预算 |
| 至少两份 Memory 文件(规则 + 历史) | 一段时间后所有记忆变垃圾 |
| Tool 用统一装饰器 + Schema | 每加一个 tool 都要改三处 |
| Option Card 类结构化交互 | UX 全靠 Agent 写文字解释,体验差 |
自检:上表 7 项你的项目占了几项?少于 5 项 = 还是 Demo,离生产还远。
Part 6 · 业务思维 · Copilot vs Autopilot · 7 维评估
 Image
6.1 红杉框架(Julien Bek)
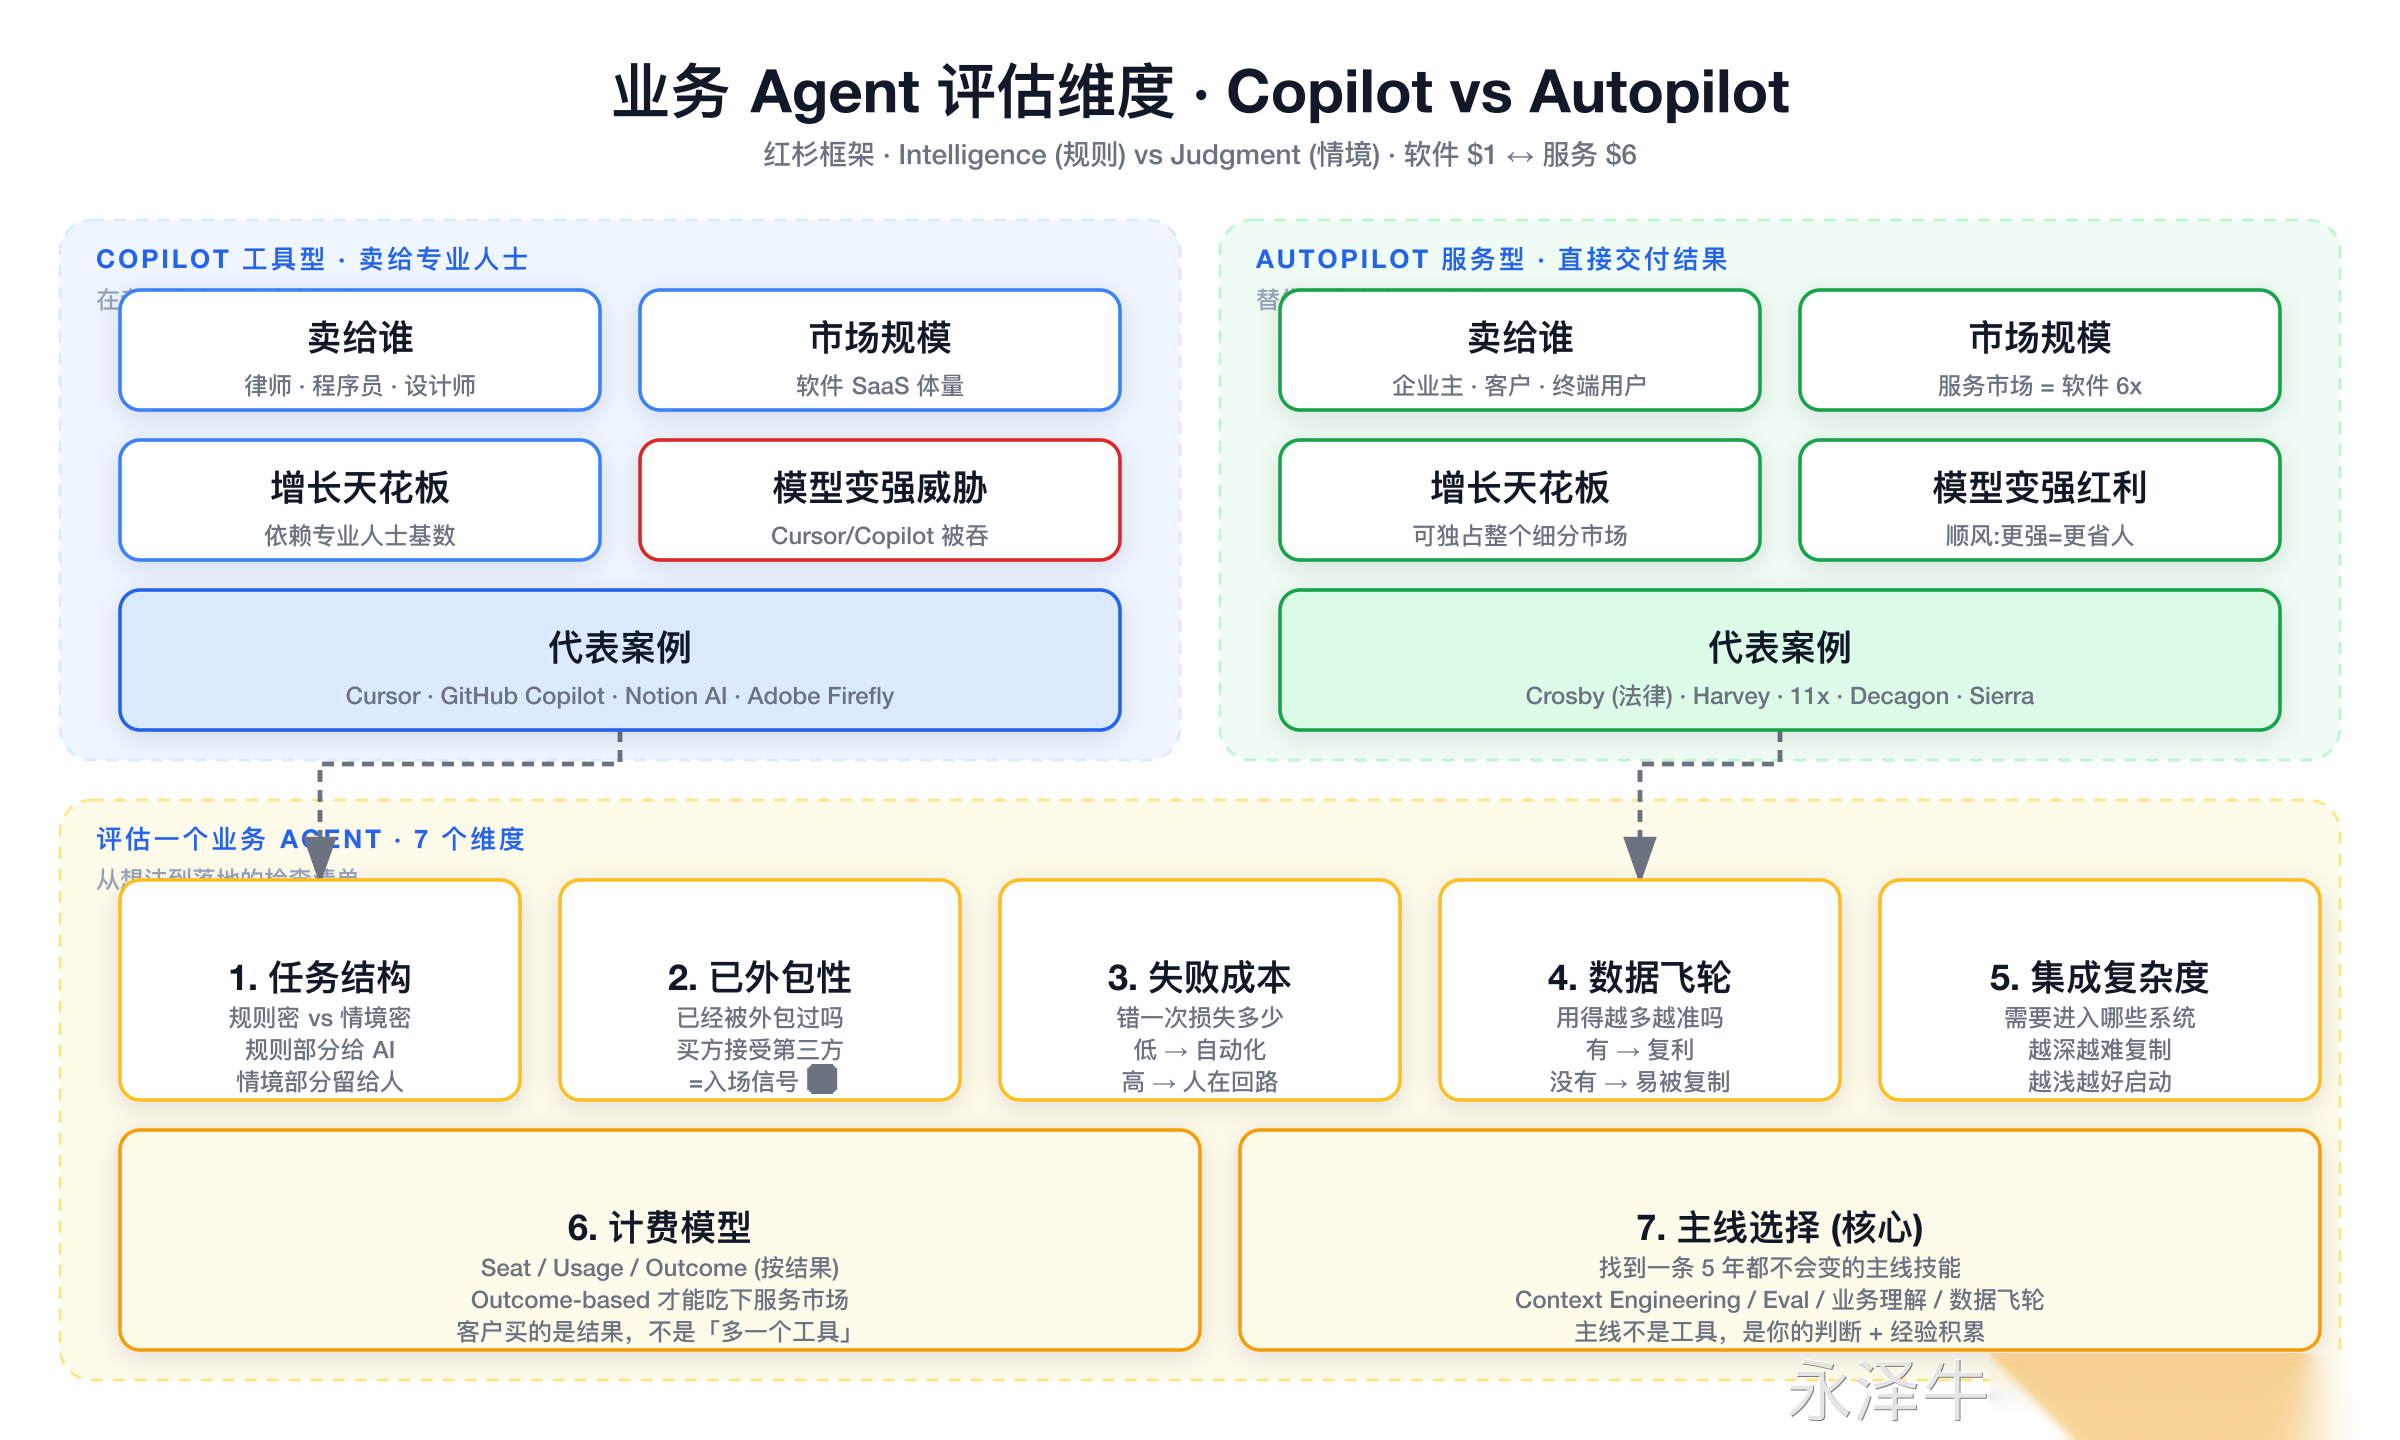
软件市场 $1,服务市场 $6。Autopilot 吃服务市场,Copilot 吃软件市场。
| 维度 | Copilot 工具型 | Autopilot 服务型 |
|---|---|---|
| 卖给谁 | 专业人士(律师、程序员、设计师) | 企业主 / 客户 / 终端用户 |
| 市场 | 软件 SaaS 体量 | 服务市场 = 软件 6x |
| 增长天花板 | 依赖专业人士基数 | 可独占整个细分市场 |
| 模型变强 | 威胁(Cursor 怕被 GPT 吞) | 红利(更强 = 更省人) |
| 代表 | Cursor, GitHub Copilot, Notion AI | Crosby (法律), Harvey, 11x, Decagon, Sierra |
核心判断:模型变强对你的业务是顺风还是逆风?逆风的方向慎入。
6.2 评估业务 Agent 的 7 个维度
- 任务结构 — 规则密 vs 情境密。规则部分给 AI,情境部分留给人
- 已外包性 — 这事已经被外包过吗?买方接受第三方 = 入场信号 ✅
- 失败成本 — 错一次损失多少?低 → 自动化,高 → 人在回路
- 数据飞轮 — 用得越多越准吗?有 → 复利护城河,没有 → 易被复制
- 集成复杂度 — 需要进入哪些系统?越深越难复制,越浅越好启动
- 计费模型 — Seat / Usage / Outcome (按结果)。Outcome-based 才能吃服务市场
- 主线选择(核心)— 找到一条 5 年都不会变的主线技能
6.3 你的「主线」是什么?
不是工具,是你的判断 + 经验积累:
- Context Engineering(怎么给 LLM 喂上下文)
- Eval 设计(怎么定义「好」)
- 业务理解(哪些环节真值钱)
- 数据飞轮设计(怎么让用得多变成护城河) 工具会过时,主线不会。 学 LangChain 早晚被替代,学「怎么设计 Eval」一辈子受益。
Part 7 · 动手 Roadmap · 用步骤代替日历
没有项目沉淀的学习都是错觉。这一节最重要。但不要把它当作一份 90 天倒计时 —— 当作一条逐步加深的路径。每一步都告诉你「做什么、怎么做、做到什么算过关」,至于花多长时间,按你自己的节奏来。
Step 1 · 跑通最简 Agent
- 选一个抽象最少的框架:Pydantic AI 或 smolagents,10 行代码起步
- 接入一个搜索工具(Tavily / Exa 都有免费额度)
- 过关标准:Agent 自己搜资料 + 回答一个需要查证的问题
Step 2 · 搭起完整的 ReAct 循环
- 升级到一个真正的编排框架:LangGraph 是当前最稳的选择
- 给 Agent 加 3 个工具:搜索 / 读文件 / 写文件
- 接 LangSmith / Langfuse / Phoenix 看完整 Trace
- 过关标准:能让 Agent 完成「调研某话题 → 输出报告到本地」这类多步任务,且 Trace 你能看懂
Step 3 · 给 Agent 加上记忆
- 接 Chroma 或 Qdrant 当 Vector DB
- 实现一个简单的 Mem0 风格记忆层(user_facts 表 + 检索)
- 把对话历史压缩 + 索引
- 过关标准:第二次对话时 Agent 能记得你上次说过的关键信息
Step 4 · 多 Agent 协作
- 用 CrewAI 或 LangGraph 实现一个 3-Agent 流水线(研究员 + 写手 + 编辑)
- 同一个任务用 Sub-Agent 模式再写一遍
- 比较两种模式在上下文消耗、可控性、调试难度上的差异
- 过关标准:能讲清楚什么时候该用 Sub-Agent,什么时候该用 Team
Step 5 · 把 Eval 当一等公民
- 给你的 Agent 设计 5 条评估标准(成功率 / 调用次数 / 成本 / 延迟 / 用户满意度)
- 用 LangSmith Eval 或 Ragas 跑批
- 找出失败 case,做归因(Harness 问题?模型问题?Tool 问题?)
- 过关标准:能画出 Agent 的失败率分布图,并知道下一步该改哪里
Step 6 · 上线 + 业务化
- 部署到 Vercel / Railway / 自己 VPS(带监控)
- 找 5 个真实用户用一周,收集反馈
- 用 Part 6 的 7 维框架评估你的项目
- 过关标准:清晰回答「这东西到底解决谁的什么问题,凭什么收钱」
走完这条路你应该具备的能力
- ✅ 看 Agent 论文 / 博客能直接 map 到代码
- ✅ 选型时能权衡而不是盲选
- ✅ 出 bug 知道先排 Harness 还是先怪模型
- ✅ 能从业务角度判断一个 Agent 项目值不值得做 节奏建议:每一步至少花一周以上,做扎实远比赶进度重要。卡住的时候允许停下补 Part 1-6 的概念,比硬推进度强。
Part 8 · 持续学习资料库
所有链接为 2026-05-26 时点的公开资源。如有失效,按论文 / 项目名称重新检索即可。
8.1 必读论文 / 博客
| 来源 | 内容 | 链接 |
|---|---|---|
| Anthropic | Building Effective Agents | https://www.anthropic.com/research/building-effective-agents |
| Anthropic | Effective Context Engineering for AI Agents | https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents |
| Anthropic | Engineering Blog(Harness 系列实验) | https://www.anthropic.com/engineering |
| Lilian Weng | LLM Powered Autonomous Agents(2023,仍是最好的入门) | https://lilianweng.github.io/posts/2023-06-23-agent/ |
| Letta | MemGPT 论文 — 长期记忆开山之作 | https://arxiv.org/abs/2310.08560 |
| Mem0 | 当前最热的 Memory 中间件 | https://mem0.ai/ |
| LangGraph | 官方文档 | https://langchain-ai.github.io/langgraph/ |
| AutoGen | 官方文档 | https://microsoft.github.io/autogen/ |
| CrewAI | 官方文档 | https://docs.crewai.com/ |
| OpenAI | Agents SDK 文档 | https://openai.github.io/openai-agents-python/ |
| Agent Development Kit (ADK) 官方文档 | https://google.github.io/adk-docs/ | |
| Firebase | Genkit 官方文档 | https://genkit.dev/ |
| Vercel | AI SDK 官方文档 | https://ai-sdk.dev/ |
| Mastra | Mastra 官方文档 | https://mastra.ai/ |
| Pydantic AI | Pydantic AI 官方文档 | https://ai.pydantic.dev/ |
8.2 必看 GitHub 项目
| 项目 | 说明 | 链接 |
|---|---|---|
| AutoGPT | Agent 启蒙项目(看历史) | https://github.com/Significant-Gravitas/AutoGPT |
| GPT-Engineer | 早期代码 Agent 流派 | https://github.com/gpt-engineer-org/gpt-engineer |
| MetaGPT | 多 Agent 软件公司模拟 | https://github.com/geekan/MetaGPT |
| AutoGen | 微软多 Agent 框架 | https://github.com/microsoft/autogen |
| CrewAI | 角色分工流派代表 | https://github.com/crewAIInc/crewAI |
| LangGraph | Stateful Agent 编排 | https://github.com/langchain-ai/langgraph |
| smolagents | HuggingFace 极简框架(Code-as-Action) | https://github.com/huggingface/smolagents |
| Mem0 | Memory 中间件 | https://github.com/mem0ai/mem0 |
| Letta(前 MemGPT) | 分层记忆参考实现 | https://github.com/letta-ai/letta |
| OpenManus | 通用 Agent 探索 | https://github.com/mannaandpoem/OpenManus |
| Cline | 代码 Agent 应用层标杆 | https://github.com/cline/cline |
| Continue | 开源 IDE Agent | https://github.com/continuedev/continue |
| OpenAI Swarm | 极简 Agent 范式(已迁移到 Agents SDK) | https://github.com/openai/swarm |
| Google ADK (Python) | Google ADK 多语言主仓 | https://github.com/google/adk-python |
| Google ADK (Java) | Google ADK Java 实现 | https://github.com/google/adk-java |
| Firebase Genkit | Genkit 主仓(JS/Go/Python/Dart) | https://github.com/firebase/genkit |
| Vercel AI SDK | TypeScript Agent / 流式优先 ADK | https://github.com/vercel/ai |
| Mastra | TypeScript Workflow + Agent + RAG | https://github.com/mastra-ai/mastra |
| Microsoft Agent Framework | .NET / Python 多 Agent 框架 | https://github.com/microsoft/agent-framework |
| Pydantic AI | 类型安全的 Python Agent 框架 | https://github.com/pydantic/pydantic-ai |
8.3 必看商业分析
- Sequoia Capital Perspectives —— Copilot vs Autopilot / Services-as-Software 系列: https://www.sequoiacap.com/perspective/
- a16z AI 主题文章: https://a16z.com/ai/
- Latent Space 播客(Smol AI 出品): https://www.latent.space/
8.4 中文优质源
- 量子位: https://www.qbitai.com/
- 机器之心: https://www.jiqizhixin.com/
- 宝玉的博客: https://baoyu.io/
- 九原客: https://9hills.github.io/
8.5 工具账号(注册免费层先)
- LangSmith: https://smith.langchain.com/
- Langfuse: https://langfuse.com/
- Phoenix(Arize): https://phoenix.arize.com/
- OpenRouter: https://openrouter.ai/
- LiteLLM: https://docs.litellm.ai/
- Tavily: https://tavily.com/
- Exa: https://exa.ai/
收尾 · 三句话总结
- 模型选 SOTA,主战场是 Harness。 这是 IT 工程师的主场,迭代速度快 1000 倍。
- Memory + Tools + Eval 是 Agent 工程化的三根支柱。 任何一根弱都会让产品在生产环境塌掉。
- 找一条 5 年不变的主线(Context Engineering / Eval / 业务理解 / 数据飞轮),围绕它积累。 工具会被替代,判断不会。