


LoRA微调原理
本文参考的一些视频链接:【【LoRA微调】从原理到调参,7 个问题彻底理解LoRA,不懂线性代数也没问题_大模型微调_低秩适配】https://www.bilibili.com/video/BV1waZ2YDEcp?vd_source=c9d260ed059bfe9d798d78ffbd12e...
本文参考的一些视频链接:
【【LoRA微调】从原理到调参,7 个问题彻底理解LoRA,不懂线性代数也没问题_大模型微调_低秩适配】https://www.bilibili.com/video/BV1waZ2YDEcp?vd_source=c9d260ed059bfe9d798d78ffbd12e55a
Image
背景
随着大语言模型(Large Language Models, LLMs)参数规模不断扩大,从数十亿到数百亿甚至万亿级,全参数训练和微调的成本迅速攀升。显存消耗大、训练周期长、分布式通信开销高,已经成为制约大模型落地应用的重要因素。
在真实工程场景中,我们往往并不需要“重塑”整个模型,而只是希望它在某一垂直领域或具体任务上表现得更好,例如:
- 客服问答
- 法律 / 医疗文本分析
- 企业内部知识问答
- 风格化生成(语气、格式、偏好) 因此,如何以更低的成本对大模型进行高效微调,成为一个关键问题。在这一背景下,参数高效微调(PEFT, Parameter-Efficient Fine-Tuning)方法应运而生,LoRA 是其中最具代表性的方案之一。
全参数微调
基本思想
全参数微调指在下游任务训练时,对模型中的所有参数进行反向传播和更新。
对于 Transformer 中的线性层:
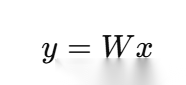 image.png
在微调过程中,权重更新为:
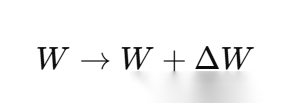 image.png
其中ΔW 是一个与 W 同维度的完整矩阵。
优点
- 表达能力最强
- 理论上可以充分适配下游任务
- 训练过程稳定
局限性
- 显存占用极高(参数、梯度、优化器状态)
- 训练和通信成本大,对多卡依赖强
- 任务切换成本高,每个任务都需要保存一整套模型参数 当模型规模达到数十亿参数后,全参数微调在大多数应用场景中已不再经济。
lora微调
核心思想
LoRA 的核心思想可以概括为一句话:
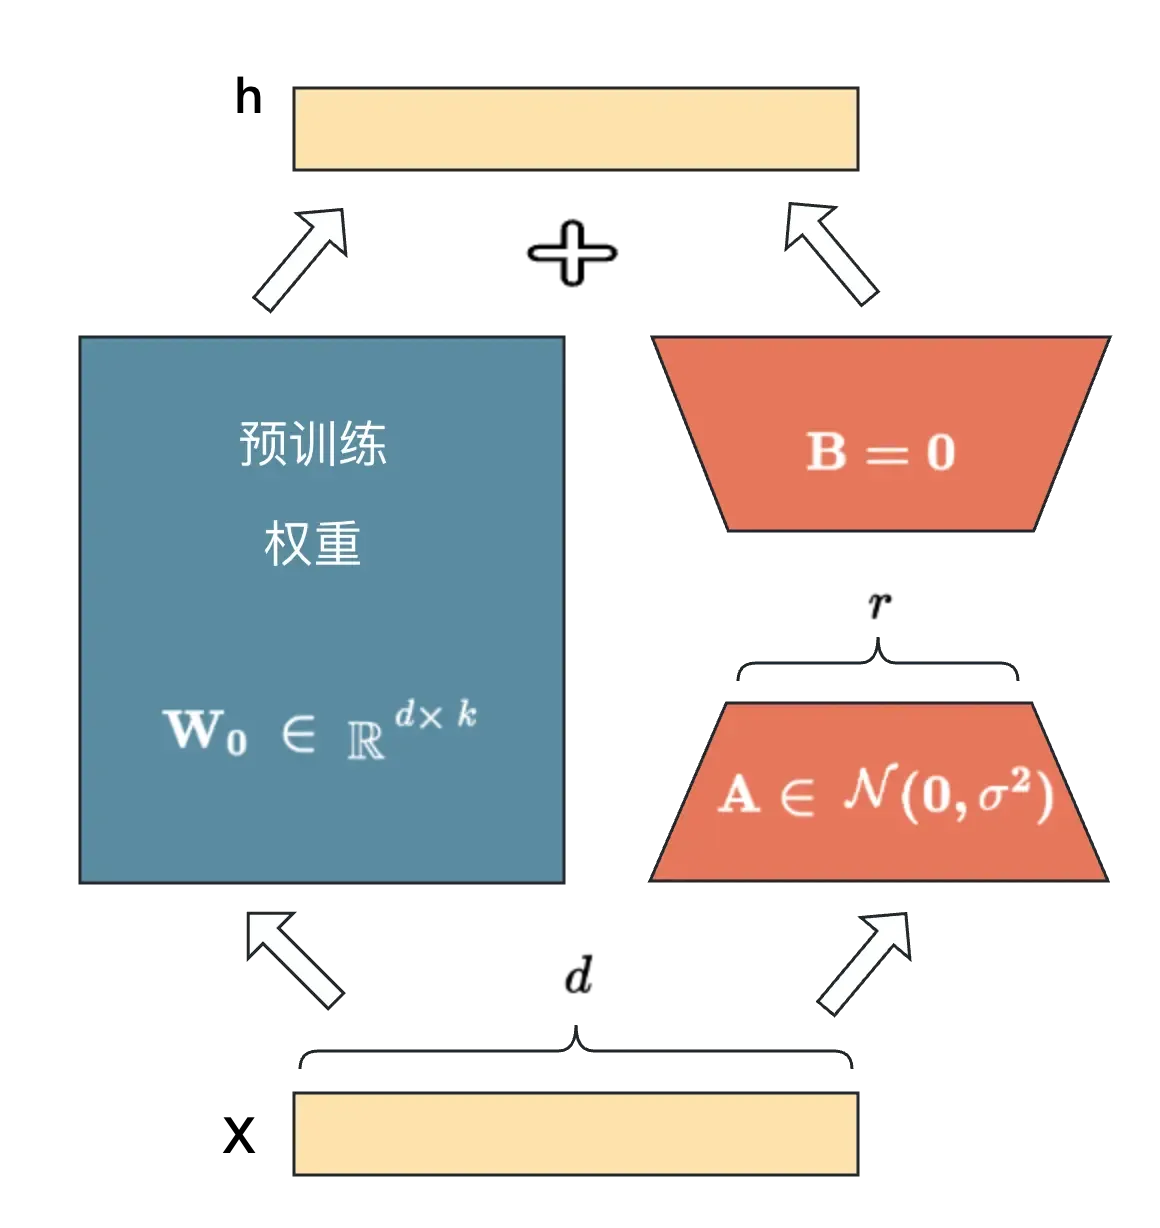
冻结原模型参数,仅通过学习一个低秩的权重增量来适配下游任务。
在 LoRA 中,预训练模型参数保持不变,只在关键线性层旁边引入少量可训练参数。
LoRA 的直觉理解
虽然模型的权重矩阵维度很高,但在具体下游任务中,真正有效的权重更新往往集中在一个低维子空间中。因此,没有必要学习一个完整的 ΔW\Delta WΔW,只需用低秩矩阵近似即可。
lora微调数学原理
低秩分解建模
对于原始线性层:
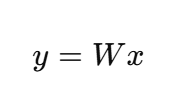 image.png
LoRA 假设微调引入的权重变化满足:
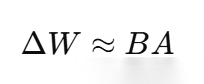 image.png
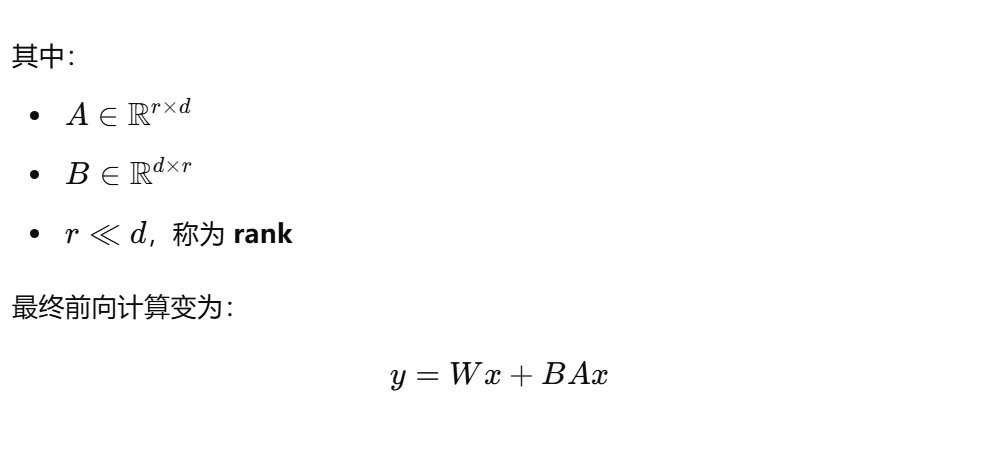 image.png
4.2 参数更新策略
- 原始权重 W 冻结,不参与训练
- 仅对 A、B 进行反向传播和更新 在训练初期,通常将 B 初始化为零矩阵,使模型初始行为与原模型保持一致,保证训练稳定性。
4.3 参数量对比
以 d=4096d = 4096d=4096、r=8r = 8r=8 为例:
- 全参数微调:4096 × 4096 ≈ 1600 万参数
- LoRA 微调:2 × 4096 × 8 ≈ 6.5 万参数 参数量减少约 200 倍以上。
lora微调实践
插入位置选择
在 Transformer 架构中,LoRA 通常应用于 Attention 相关线性层:
Query (Q)
Key (K)
Value (V)
Output (O)
工程实践中:
Q、V 层最常用,效果稳定
是否作用于 K、O 层需结合任务验证
训练流程
加载预训练大模型
冻结原模型参数(requires_grad = False)
在指定线性层注入 LoRA 模块
仅优化 LoRA 参数
这种方式显著降低了显存占用,并支持在单卡甚至消费级显卡上完成微调。
推理与部署
LoRA 支持两种推理方式:
- 动态注入:推理时实时计算 𝑊𝑥+𝐵𝐴𝑥,支持多 LoRA 热切换
- 权重合并(Merge):将 𝐵𝐴合并进原权重,推理无额外开销 这使得 LoRA 非常适合多任务、多风格模型部署场景。
实践经验与注意事项
rank 选择对效果敏感,常见取值为 4 / 8 / 16
数据质量对 LoRA 效果影响显著
LoRA 更适合“能力迁移”和“风格调整”,而非从零学习新能力
小结
LoRA 通过低秩分解的方式,将大模型微调问题转化为一个参数高效、稳定且易部署的工程方案。在当前大模型应用普遍追求低成本、快迭代、多任务的背景下,LoRA 已成为工业界和研究领域的主流选择之一。