


提升大模型RAG准确率的一些小技巧
前言
如何高效提升大模型RAG的准确率?
这个问题是一个最近大家都比较关心的公共问题。
今天这篇文章就专门跟大家一起聊聊提升RAG准确率的一些小技巧,希望对你会有所帮助。
一、RAG效果不好,到底卡在哪?
很多人以为RAG就是“文档切一切→向量化→丢给大模型”,就跑完了。
结果跑出来效果拉跨,还一脸懵逼:我都照教程做了啊。
RAG的完整流程其实是这样的:
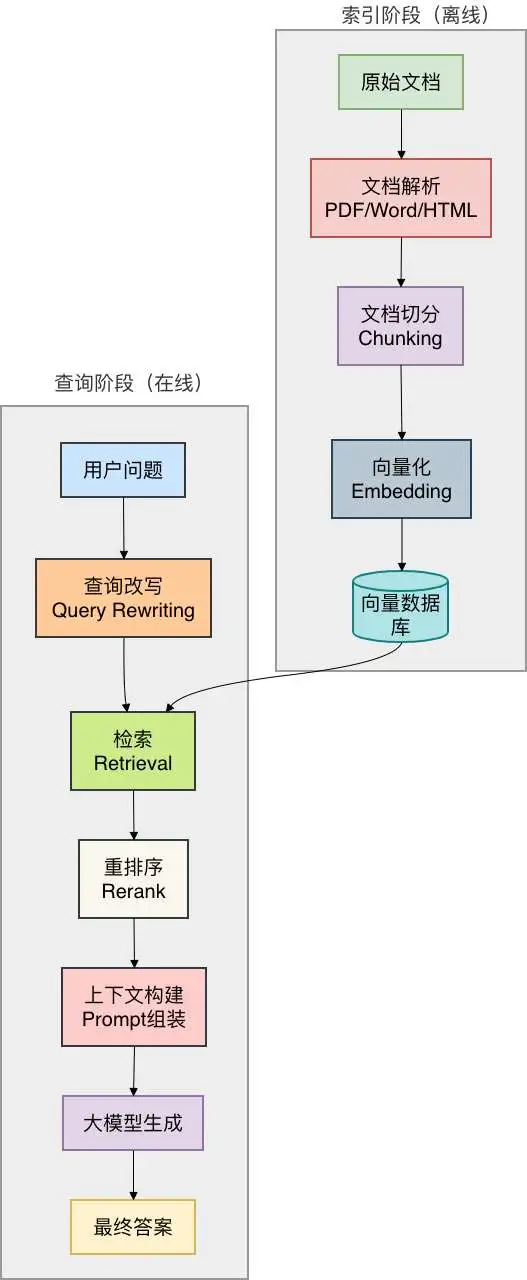
任何一个环节出问题,整个效果都会崩。
在“向量化”这一步死磕,换了好几个embedding模型,结果提升不到5%。
为啥?因为问题根本不在那儿。
下面我把每个环节拆开来讲,希望对你会有所帮助。
二、文档解析
你喂给RAG的是“干净数据”还是“垃圾”?
很多小伙伴工作中可能会遇到这种情况:从公司内部系统导出一堆PDF、Word文档,直接扔进去切分。
结果发现很多文档里全是扫描件(图片格式),一个字都提不出来;或者表格被拆得支离破碎,完全丢了语义。
2.1 问题出在哪
大多数RAG教程用的示例文档都是规整的txt或md文件,但真实世界里的文档啥样都有:
扫描版PDF:其实就是一张张图片,你不做OCR,一个字都捞不到
Word里的表格:直接转成纯文本后,行列关系全乱了
PPT课件:一页一页的,每页只有几个bullet point,直接切分后上下文碎片化严重
带页眉页脚的技术文档:每一段都会带上页眉,切出来的chunk里全是“第xx页共xx页”这种无效信息
2.2 怎么破?
方案一:PDF先做OCR再提取。
扫描件PDF别省事儿,一定要跑一遍OCR。
推荐用PaddleOCR或Tesseract,我们实测PaddleOCR中文效果更好。
Python
import fitz  # PyMuPDF
from paddleocr import PaddleOCR

ocr = PaddleOCR(use_angle_cls=True, lang='ch')

def pdf_to_text_with_ocr(pdf_path):
    doc = fitz.open(pdf_path)
    full_text = []
    for page in doc:
        # 先检查页面是不是纯文本
        text = page.get_text()
        if len(text.strip()) < 50:  # 文字太少,怀疑是扫描件
            # 把页面转成图片
            pix = page.get_pixmap()
            img_path = f"temp_page_{page.number}.png"
            pix.save(img_path)
            # OCR识别
            result = ocr.ocr(img_path, cls=True)
            page_text = ''
            for line in result[0]:
                page_text += line[1][0] + '\n'
            full_text.append(page_text)
        else:
            full_text.append(text)
    return '\n'.join(full_text)
方案二:表格单独处理。
Word和PDF里的表格,提取成markdown格式比纯文本好得多,因为大模型能理解表格结构。
Python
import pandas as pd
from docx import Document

def extract_tables_from_docx(docx_path):
    doc = Document(docx_path)
    tables_markdown = []
    for table in doc.tables:
        # 转成pandas DataFrame
        data = []
        for row in table.rows:
            row_data = [cell.text for cell in row.cells]
            data.append(row_data)
        df = pd.DataFrame(data[1:], columns=data[0]) if len(data) > 1 else pd.DataFrame(data)
        tables_markdown.append(df.to_markdown())
    return '\n\n'.join(tables_markdown)
方案三:元数据附加。
每个chunk生成的时候,把来源文档的名称、章节标题、创建时间作为元数据附加上。
这样检索的时候可以按文档来源过滤,也方便大模型引用出处。
Python
chunk_metadata = {
    "source_file": "2025年销售报告.pdf",
    "section": "第三章 华东区销售数据",
    "page": 23,
    "created_at": "2025-12-01"
}
避坑提醒:元数据不要塞太多,2-3个关键字段就够了。
塞多了embedding的时候反而会稀释正文内容的权重。
三、文档切分
切分这一步是RAG的“命门”。
切太小了,上下文丢失语义;切太大了,检索精准度下降,而且token消耗爆炸。
切错了,神仙也救不回来。
3.1 常见切分方式的对比
固定长度
按500/1000字硬切
简单、可控
把一句话拦腰切断,语义全毁
按句子切
用句号/换行分割
保正句子完整性
单个句子信息量太少
按段落切
用空行分割
保正语义单元
段落太长时检索不精准
递归切分
从段落→句子→固定长度,逐级降级
灵活、兼顾语义
实现稍微复杂
语义切分
用embedding计算相邻句子的相似度,相似度突降时切
保正主题一致性
成本高、慢
3.2 常见的切分方案
方案一:递归切分(RecursiveCharacterTextSplitter)。
这个方案已经是最佳实践了,LangChain里有现成的。
它的逻辑是:优先按段落切,段落太长就按句子切,句子太长再按固定长度硬切。
Python
from langchain.text_splitter import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
    chunk_size=800,        # 每个chunk目标大小(字符数)
    chunk_overlap=200,     # 重叠长度,防止上下文丢失
    separators=["\n\n", "\n", "。", "!", "?", ";", ",", " ", ""]
)

chunks = splitter.split_text(long_document)
chunk_overlap很多人不重视,其实非常关键。举个例子:一段关于“Spring事务传播机制”的文字,切在两个chunk之间,前一个chunk讲完了“REQUIRED”,后一个chunk开头讲“REQUIRES_NEW”,如果没有重叠,检索的时候可能只命中后半个chunk,读不到前面的定义,答案就残了。
经验值:chunk_size在500-1000之间比较合理,overlap取chunk_size的20%-30%。
方案二:带结构的切分(MarkdownHeaderTextSplitter)。
如果文档本身是有结构的markdown,可以按标题层级来切。
每个chunk都带上完整的标题路径作为上下文。
Python
from langchain.text_splitter import MarkdownHeaderTextSplitter

headers_to_split_on = [
    ("#", "h1"),
    ("##", "h2"),
    ("###", "h3"),
]

splitter = MarkdownHeaderTextSplitter(headers_to_split_on)
splits = splitter.split_text(markdown_text)
# 每个split的metadata里会有h1, h2, h3字段
这个方案尤其适合技术文档、产品手册这类有明确章节结构的文档。
检索的时候,一个chunk里带着“第三章>第二节>建表语句”这样的路径信息,大模型理解上下文会准确得多。
避坑提醒:不要一刀切地用固定chunk_size。不同类型的文档应该用不同的切分策略:FAQ类适合按问题切、长文章适合递归切、代码库适合按函数切。我们团队的做法是维护一个切分配置表,按文档类型走不同的管道。
四、向量化(Embedding)
很多人在这一步花大量时间换embedding模型,从text-embedding-ada-002换到bge-large-zh,换到m3e,折腾一圈发现提升有限。
为啥?因为embedding模型是“通用的”,它不可能懂你业务的专有名词。
4.1 embedding模型的核心能力
embedding的本质是把文本映射到一个高维向量空间,语义相近的文本在这个空间里距离更近。
不同模型的能力差异主要在两方面:
语言的覆盖度:中文、英文、多语言混合哪个更强
句子长度:有些模型擅长短文本(比如256 token以内),有些能处理长文本(8192 token)
但你得明白:embedding模型不是你业务的“语义专家”。如果你的文档里全是“SKU”、“PO单”、“BOM表”这些行业术语,换什么通用模型都白搭。
4.2 真正有效的方案
方案一:微调embedding模型。 用你自己的业务数据去微调模型,让模型学会议“PO单”和“采购订单”说的是同一回事。微调需要准备正样本对(语义相似的句子对)和负样本对(语义不同的句子对)。
Python
# 伪代码示意
train_data = [
    ("用户要求退款", "客户申请退货", 1),   # 正样本,标签=1
    ("用户要求退款", "系统维护公告", 0),   # 负样本,标签=0
    # ... 收集1000+对
]
# 用sentence-transformers框架微调
微调的门槛不算太高,几百到一千条标注数据就能看到明显效果。我们团队用300条人工标注的正负样本微调bge-large-zh后,域内检索准确率从68%提到了82%。
方案二:关键词+向量混合检索。
纯向量检索对专有名词的命中效果不好,因为“PO-202400123”这种字符串的语义太稀疏。
混合检索的思路是:先用关键词检索(BM25或Elasticsearch)捞一批候选,再用向量检索做精排。
Python
from rank_bm25 import BM25Okapi

# 建BM25索引
tokenized_corpus = [doc.split() for doc in corpus]
bm25 = BM25Okapi(tokenized_corpus)

# 混合检索
query = "订单PO-202400123的物流状态"
bm25_results = bm25.get_top_n(query.split(), corpus, n=20)
vector_results = vector_store.similarity_search(query, k=20)

# 合并去重后重排序
final_candidates = list(set(bm25_results + vector_results))
混合检索的效果通常比纯向量检索好15-20个百分点,尤其在专有名词、编号、代码片段这些场景下效果提升特别明显。
方案三:Query改写。
用户的原始问题有时候太口语化,直接拿去检索效果不好。用大模型把用户问题改写成一个更“文档友好”的查询语句。
Python
def rewrite_query(original_query):
    prompt = f"""
    将用户的自然语言问题改写成适合检索的形式,要求:
    1. 提取关键实体(如订单号、产品名、时间范围)
    2. 用陈述句表达
    3. 去掉语气词和无关信息

    原问题:{original_query}
    改写结果:
    """
    return llm.invoke(prompt)
比如用户问“上个月那个退货单咋还没处理啊”,改写后变成“2025年5月退货单处理状态”。
这个改写后的查询跟文档内容更接近,检索准确率会高很多。
五、检索与重排序(Rerank)
召回再多不如排得准。
很多RAG系统的效果瓶颈不在“找不到相关文档”,而在“把不相关的文档排在了前面”。
大模型的上下文窗口有限,你塞进去10个chunk,只有2个相关,大模型被噪音干扰后照样答不对。
5.1 为什么要做重排序
向量检索一次可以召回几十上百条结果,但召回的列表是按向量距离排序的。这个排序是“语义相似度排序”,不是“对用户问题的相关性排序”。
举个例子:
用户问:“怎么配置数据库连接池?”
向量检索召回了:“HikariCP官方文档”、“Druid配置详解”、“连接池原理”
这三条跟用户问题的语义都很接近,但哪条最相关?“HikariCP官方文档”可能是最相关的,但如果向量模型错误地把“Druid配置”排在了第一位,结果就崩了。
Rerank模型的作用就是:用一个更精炼的模型(通常是cross-encoder架构)对召回结果重新打分排序。
5.2 主流Rerank模型对比
模型
特点
适用场景
Cohere Rerank
效果最好,有免费额度
追求极致效果,不介意调用API
BGE-Reranker
开源,可本地部署
数据敏感、无网环境
Cross-Encoder
精度高但速度慢
小数据量、对延迟不敏感
ColBERT
延迟和精度的折中
大规模检索场景
5.3 代码示例
Python
from sentence_transformers import CrossEncoder

# 加载rerank模型
reranker = CrossEncoder('BAAI/bge-reranker-v2-m3')

def rerank_results(query, candidates, top_k=5):
    # 构造(query, doc)对
    pairs = [[query, doc.page_content] for doc in candidates]
    # 计算相关性分数
    scores = reranker.predict(pairs)
    # 按分数降序排序
    scored = list(zip(candidates, scores))
    scored.sort(key=lambda x: x[1], reverse=True)
    # 取top_k
    return [doc for doc, score in scored[:top_k]]

# 使用
retrieved_docs = vector_store.similarity_search(query, k=20)
reranked_docs = rerank_results(query, retrieved_docs, top_k=5)
避坑提醒:rerank模型的计算量比embedding大很多,不要对全库做rerank,那会慢死。正确流程是:先用向量检索快速捞出top-k(比如20-50),只对这几十条做rerank,最后取top-5喂给大模型。
六、上下文构建
你喂给大模型的prompt质量决定一切。
检索回来的chunk怎么塞进prompt里,直接决定了最终答案的质量。
这一步的细节非常多,我见过太多人在这个环节翻车。
6.1 基础模板 vs 高级模板
最基础的做法就是把chunks拼在一起丢给大模型:
Python
prompt = f"""
根据以下资料回答问题:
{''.join(chunks)}

问题:{query}
"""
这种做法效果一般。更好的做法是:
1. 给每个chunk加来源标识。 这样大模型在回答时可以引用来源,增强可信度。
Python
prompt = f"""
请根据以下参考资料回答用户问题。每个参考资料都有编号[1]、[2]等。回答时请引用来源编号。

参考资料:
[1] 来自《MySQL性能优化指南》第3章:索引设计原则...
[2] 来自公司内部Wiki《订单系统设计文档》:订单表建表语句...
[3] 来自《2025年技术周报》:慢查询优化案例...

用户问题:{query}

请给出答案,并在每个关键信息后面标注来源(例如[1])。
"""
2. 使用Few-shot示例。 给大模型几个“问答示例”,它能更好地理解你期望的回答格式。
Python
prompt = f"""
请参考以下示例的格式回答问题。

示例1:
问题:如何查看MySQL版本?
答案:可以使用SELECT VERSION();命令查看MySQL版本。

示例2:
问题:Spring Boot如何配置日志级别?
答案:在application.yml中配置logging.level.root=INFO。

现在请回答:
问题:{query}
参考资料:{chunks}
答案:
"""
3. 增加“不知道就说不知道”的约束。 这个极其重要,不然大模型会硬编答案。
Python
prompt = f"""
重要规则:如果参考资料中没有明确的信息,请直接说“根据现有资料无法回答该问题”,不要编造答案。

参考资料:{chunks}

问题:{query}
答案:
"""
6.2 上下文窗口溢出怎么办
当检索回来的chunk总token数超过大模型上下文窗口时(比如你用的是max_tokens=4096的模型),必须做压缩或截断。
方案一:按相关性截断。 Rerank后的chunk列表已经按分数排好序了,取前N个直到token数超限为止。
Python
import tiktoken

enc = tiktoken.get_encoding("cl100k_base")
max_prompt_tokens = 3500  # 给回答留一些空间

selected_chunks = []
total_tokens = 0
for chunk in reranked_chunks:
    tokens = len(enc.encode(chunk.page_content))
    if total_tokens + tokens > max_prompt_tokens:
        break
    selected_chunks.append(chunk)
    total_tokens += tokens
方案二:摘要压缩。 对于特别长的chunk,让大模型先做个摘要。但注意:摘要会丢失细节,适合粗粒度信息,不适合精确数值类问题。
Python
def summarize_chunk(chunk_text):
    summary_prompt = f"请用一句话概括以下内容:\n{chunk_text}"
    return llm.invoke(summary_prompt)
6.3 多轮对话中的上下文管理
RAG系统往往需要支持多轮对话(用户追问、澄清)。你不能每次都只把“当前问题”拿去检索,要把对话历史也纳入考量。
Python
def build_context_with_history(query, history, retrieved_chunks):
    # 把历史对话也写进prompt
    history_str = "\n".join([f"用户:{h['user']}\n助手:{h['assistant']}" for h in history[-3:]])

    prompt = f"""
对话历史:
{history_str}

当前用户问题:{query}

参考资料:{retrieved_chunks}

请结合对话历史和参考资料回答问题。
"""
    return prompt
同时,检索时可以用查询重写把历史信息融合进去:
Python
def query_with_history(current_query, history):
    # 让大模型生成一个包含上下文的新查询
    prompt = f"""
    对话历史:{history}
    最新问题:{current_query}
    请把历史信息和最新问题融合成一个完整的查询语句:
    """
    return llm.invoke(prompt)
七、进阶技巧
让RAG效果再上一个台阶。
上面的基础方案跑通后,效果应该能到70%左右。
如果要突破到85%以上,下面这几个进阶技巧值得一试。
7.1 自查询检索器(Self-Query Retriever)
传统的检索只能按文本相似度找,但用户常常会问带条件的问题,比如“查一下2025年6月的销售数据,只要华东区的”。
Self-Query的思想是:让大模型先解析用户问题,提取出查询语句和过滤条件,然后用元数据过滤去检索。
Python
from langchain.retrievers.self_query.base import SelfQueryRetriever

# 定义元数据字段
metadata_fields = [
    AttributeInfo(name="year", description="文档所属年份", type="int"),
    AttributeInfo(name="region", description="区域:华东/华南/华北", type="string"),
    AttributeInfo(name="doc_type", description="文档类型:销售报告/技术文档", type="string"),
]

retriever = SelfQueryRetriever.from_llm(
    llm=llm,
    vectorstore=vector_store,
    document_contents="公司销售数据和技术文档",
    metadata_field_info=metadata_fields,
)
用户问“2025年华东区的销售数据”,SelfQueryRetriever会自动提取出:query=“销售数据”,filter={"year": 2025, "region": "华东"}。
7.2 多路召回与融合
不要只依赖一种检索方式。向量检索、关键词检索、SQL查询、API调用都可以作为不同的“召回源”,然后把结果融合起来。
Python
def multi_path_retrieve(query):
    results = []
    # 路径1:向量检索
    results.extend(vector_store.similarity_search(query, k=10))
    # 路径2:BM25关键词检索
    results.extend(bm25_search(query, k=10))
    # 路径3:如果是产品编号,直接查数据库
    if re.match(r'^PO-\d{9}$', query):
        db_result = db.query(f"SELECT * FROM orders WHERE order_id='{query}'")
        results.append(db_result)
    # 去重后rerank
    return deduplicate_and_rerank(results)
7.3 假设性文档嵌入(HyDE)
当用户的问题非常抽象时,直接拿问题去检索可能效果不好。HyDE的思路是:先让大模型假设已经找到了答案,根据这个假设生成一段虚拟文档,再用虚拟文档去检索。
Python
def hyde_retrieve(query):
    # 1. 让大模型生成一个假设性的答案(虚拟文档)
    hypothetical_doc = llm.invoke(f"请回答以下问题,写一段详细的答案:{query}")

    # 2. 用虚拟文档去向量库检索
    real_docs = vector_store.similarity_search(hypothetical_doc, k=10)

    return real_docs
举个例子,用户问“那个很火的数据库迁移工具叫啥来着?”直接检索很难匹配。
HyDE先生成一段描述“Flyway是一个开源的数据库版本管理工具,支持SQL脚本迁移...”,然后用这段描述去匹配“Flyway”的文档。
HyDE在查询很短、信息量很少的场景下效果提升明显,但注意它也会引入“幻觉”——生成的虚拟文档可能不准确,导致检索偏离。建议只在查询长度<5个词时启用。
7.4 窗口检索
如果一个文档被切成了很多chunk,用户问的问题可能需要跨多个chunk的信息才能回答。
窗口检索的做法是:当命中一个chunk时,把它的前后N个chunk也一起带上。
Python
def retrieve_with_window(chunk_id, chunks_list, window_size=2):
    start = max(0, chunk_id - window_size)
    end = min(len(chunks_list), chunk_id + window_size + 1)
    return chunks_list[start:end]
这个方案在长文档、需要上下文连贯的场景(比如论文、技术手册)里非常有效。
7.5 小型专用的索引 vs 一个万能的大索引
很多团队上来就想建一个大索引,把所有文档往里塞。结果发现:技术文档和客服FAQ混在一起,检索时互相干扰。
更好的做法是:按领域拆分索引。技术文档一个索引,客服对话一个索引,产品手册一个索引。
查询的时候先识别用户意图(用个小模型分类),然后只在对应的索引里检索。
Python
def classify_intent(query):
    # 用轻量级分类器判断
    # 返回: 'tech_doc' / 'customer_service' / 'product_manual'
    return intent

def route_query(query):
    intent = classify_intent(query)
    if intent == 'tech_doc':
        return tech_vectorstore.similarity_search(query)
    elif intent == 'customer_service':
        return service_vectorstore.similarity_search(query)
    else:
        return product_vectorstore.similarity_search(query)
八、一个生产级RAG管道的Java实现
上面讲了这么多理论和Python示例,考虑到很多小伙伴是Java技术栈,下面用Java完整实现一个RAG管道。
这里用了Spring AI + Chroma向量库。
Java
package com.example.rag;

import org.springframework.ai.document.Document;
import org.springframework.ai.embedding.EmbeddingClient;
import org.springframework.ai.vectorstore.VectorStore;
import org.springframework.ai.vectorstore.chroma.ChromaVectorStore;
import org.springframework.ai.vectorstore.filter.Filter;
import org.springframework.ai.vectorstore.filter.FilterExpressionBuilder;
import org.springframework.stereotype.Service;
import reactor.core.publisher.Flux;

import java.util.*;
import java.util.stream.Collectors;

@Service
public class RAGPipeline {

    private final VectorStore vectorStore;
    private final EmbeddingClient embeddingClient;
    private final ChatClient chatClient;
    private final RerankerService reranker;
    private final QueryRewriter queryRewriter;

    public RAGPipeline(VectorStore vectorStore,
                       EmbeddingClient embeddingClient,
                       ChatClient.Builder chatBuilder,
                       RerankerService reranker,
                       QueryRewriter queryRewriter) {
        this.vectorStore = vectorStore;
        this.embeddingClient = embeddingClient;
        this.chatClient = chatBuilder.build();
        this.reranker = reranker;
        this.queryRewriter = queryRewriter;
    }

    /**
     * 完整的RAG问答流程
     */
    public String ask(String userQuestion) {
        return askWithHistory(userQuestion, Collections.emptyList());
    }

    public String askWithHistory(String userQuestion, List<Map<String, String>> history) {
        // 1. 查询改写(含多轮对话上下文)
        String rewrittenQuery = queryRewriter.rewriteWithHistory(userQuestion, history);

        // 2. 检索(多路召回)
        List<Document> retrieved = multiPathRetrieve(rewrittenQuery);

        // 3. 重排序
        List<Document> reranked = reranker.rerank(rewrittenQuery, retrieved, 5);

        // 4. 构建prompt(带元数据)
        String prompt = buildPrompt(reranked, userQuestion, history);

        // 5. 调用大模型生成答案
        return chatClient.prompt(prompt).call().content();
    }

    private List<Document> multiPathRetrieve(String query) {
        Set<String> seenIds = new HashSet<>();
        List<Document> all = new ArrayList<>();

        // 路径1:向量检索
        List<Document> vecResults = vectorStore.similaritySearch(query, 20);
        for (Document doc : vecResults) {
            if (seenIds.add(doc.getId())) {
                all.add(doc);
            }
        }

        // 路径2:关键词检索(模拟,实际可用ES或Lucene)
        List<Document> kwResults = keywordSearch(query, 20);
        for (Document doc : kwResults) {
            if (seenIds.add(doc.getId())) {
                all.add(doc);
            }
        }

        // 路径3:如果是数字ID,直接查元数据
        if (query.matches("\\d+")) {
            Filter filter = new FilterExpressionBuilder().eq("id", query).build();
            List<Document> idResults = vectorStore.similaritySearch(
                SearchRequest.query(query).withFilter(filter).withTopK(10));
            for (Document doc : idResults) {
                if (seenIds.add(doc.getId())) {
                    all.add(doc);
                }
            }
        }

        return all;
    }

    private String buildPrompt(List<Document> docs, String question, List<Map<String, String>> history) {
        StringBuilder context = new StringBuilder();
        int idx = 1;
        for (Document doc : docs) {
            String source = doc.getMetadata().getOrDefault("source", "未知来源");
            String page = doc.getMetadata().getOrDefault("page", "");
            context.append(String.format("[%d] 来源:%s", idx++, source));
            if (!page.isEmpty()) {
                context.append(" 第").append(page).append("页");
            }
            context.append("\n").append(doc.getContent()).append("\n\n");
        }

        StringBuilder historyStr = new StringBuilder();
        if (!history.isEmpty()) {
            historyStr.append("对话历史:\n");
            for (Map<String, String> turn : history) {
                historyStr.append("用户:").append(turn.get("user")).append("\n");
                historyStr.append("助手:").append(turn.get("assistant")).append("\n");
            }
            historyStr.append("\n");
        }

        return String.format("""
            你是一个专业的问答助手。请基于以下参考资料回答用户问题。

            重要规则:
            1. 如果参考资料中没有明确信息,请直接回答"根据现有资料无法回答该问题"。
            2. 回答时请在每个关键信息后标注来源编号,例如[1]。
            3. 答案要准确、简洁、有条理。

            %s
            参考资料:
            %s
            用户问题:%s

            答案:
            """, historyStr.toString(), context.toString(), question);
    }

    private List<Document> keywordSearch(String query, int topK) {
        // 简化实现:实际可以用Elasticsearch或Lucene
        // 这里仅示意
        return new ArrayList<>();
    }
}
对应的查询重写器实现:
Java
@Component
public class QueryRewriter {

    private final ChatClient chatClient;

    public QueryRewriter(ChatClient.Builder builder) {
        this.chatClient = builder.build();
    }

    public String rewriteWithHistory(String query, List<Map<String, String>> history) {
        if (history.isEmpty()) {
            return rewrite(query);
        }

        String historyText = history.stream()
            .map(turn -> "用户:" + turn.get("user") + "\n助手:" + turn.get("assistant"))
            .collect(Collectors.joining("\n"));

        String prompt = String.format("""
            对话历史:
            %s

            最新用户问题:%s

            请结合对话历史,把问题改写成一个完整的、独立的查询语句。
            只输出改写后的查询,不要输出其他内容。
            """, historyText, query);

        return chatClient.prompt(prompt).call().content();
    }

    public String rewrite(String query) {
        // 简单改写:去除语气词
        return query.replaceAll("啊|呢|吧|哦|呀", "").trim();
    }
}
这个Java实现涵盖了多路召回、重排序、元数据过滤、多轮对话上下文等核心能力,可以直接集成到Spring Boot项目里。
九、效果评估
没量化就别说自己提升了。
说了这么多优化手段,还有一个重要问题是:你怎么知道自己改完以后效果是真的变好了,还是心理作用?
9.1 评估指标
指标
怎么算
说明
召回率
检索到的相关文档数 / 总相关文档数
越高说明检索越全面
精准率
检索到的相关文档数 / 总检索文档数
越高说明噪音越少
MRR(平均倒数排名)
第一个正确答案排名的倒数,取平均
衡量排序质量
答案准确率
人工判断答案是否正确
最终业务指标
9.2 构建测试集
不要拍脑袋去评估。准备一套标注好的测试集,至少100-200条(问题,正确答案,对应的文档片段)。
JSON
[
  {
    "question": "如何配置Spring Boot的数据库连接池?",
    "ground_truth": "在application.yml中设置spring.datasource.hikari.*相关参数",
    "relevant_docs": ["doc_123", "doc_456"]
  }
]
每次改完代码,跑一遍测试集,对比前后指标的变化。这是唯一能科学评估RAG效果的方法。
9.3 持续迭代的建议
RAG系统没有“一次成型”的说法。上线后还得持续优化:
记录bad case:用户问什么系统没答对,人工标注出来
补充知识库:bad case往往是因为知识库里压根没有相关信息
调整切分策略:如果是某个chunk内容不全导致的,调整切分方式
重写查询模板:如果是prompt问题,微调prompt
十、总结
写到这里,我们已经把RAG从文档解析到最终生成的整条链路都过了一遍。
回头看最初那个问题——“如何高效提升RAG效果”,我的答案可以浓缩成一句话:
不要只在一个环节上死磕,整条链路都得优化,而且每个环节都有明确的优先级。
按照我们的实践,建议你按这个顺序迭代:
先做文档清洗:OCR、表格提取、元数据附加。这一步投入产出比最高,能解决50%以上的基础问题。
再优化切分策略:从固定长度切分换成递归切分,加chunk_overlap。再针对特殊文档(代码、表格)做定制化处理。
引入混合检索:向量+BM25,解决专有名词问题。这一步能让召回率提升10-15%。
加rerank:只需要在召回结果上做精排,效果立竿见影。这一步能让答案准确率提升10%左右。
最后打磨prompt:加来源标识、Few-shot、拒答规则。这一步决定了最终答案的用户体验。
如果有余力,上HyDE、Self-Query、多路召回这些进阶技巧,它们能把效果从85%往90%以上推,但边际收益递减,先保证前面的都做到位。
另外还有几个容易被忽略的点:
别把所有文档放一个索引里。按领域拆分,按意图路由,干扰少,效果好。
重视多轮对话的上下文管理。很多RAG翻车不是因为没找到资料,而是因为没把历史对话考虑进去。
建立测试集,量化评估。没有数据支撑的“我感觉变好了”在团队决策里一文不值。
希望这篇文章能让你少走一些弯路。